

- Sample: individual instance available for analysis; composed of features that describes it :
- Label: the category or target for the samples
- Dataset: the collection of data samples and labels (if any)
- Feature: attributes that describe each of the instances in the dataset
- Feature space: the high-dimensional space where data sample lie
- Training set: data samples used for training the model
- Test set: unseen samples to be predicted by the model
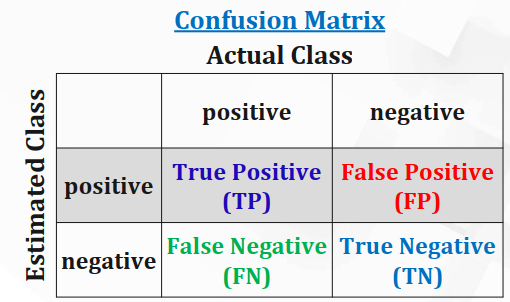
confusion metrix
二、Linear Models
引入
假设空间(Hypothesis Space)
定义
假设空间是从输入空间 到输出空间 的一组函数的集合。它是我们选择预测函数的集合。简单来说,假设空间包含了所有可能用于描述数据及其模式的候选模型。
解释
假设空间在机器学习中的作用至关重要,因为它决定了我们可以选择的模型范围。假设空间中的函数可以用来进行预测、分类或其他任务。
特性
我们希望假设空间具有以下特性:
- 连续性:函数在整个输入空间上是连续的,没有突然的跳变。
- 光滑性:函数是平滑的,没有过多的波动。
- 简单性:函数相对简单,不会过于复杂,符合奥卡姆剃刀原则(即简单模型优于复杂模型)。
- 易于操作:函数容易计算和优化。
Perceptron
1. 概述
感知机(Perceptron)是最早期的神经网络模型之一,由Frank Rosenblatt在1958年提出。它是一个二分类模型,通过线性分离超平面将输入数据分为两类。感知机是线性分类器的基础,它的简单性和直观性使其成为理解更复杂神经网络的入门点。
2. 模型结构
感知机包括以下基本部分:
- 输入层:接收特征向量 。
- 权重向量:每个输入特征对应一个权重 。
- 偏置:一个额外的常数项 ,用来调整决策边界。
- 激活函数:通常是阶跃函数(sign function),根据加权和输出分类结果。
模型的输出计算公式为:
3. 感知机算法
感知机算法通过不断调整权重向量 和偏置 来优化分类效果。其核心步骤如下:
-
初始化:
- 初始化权重向量 和偏置 为零或小随机值。
-
训练过程:
- 对每一个训练样本 进行预测:
- 如果预测正确,不做任何调整。
- 如果预测错误,根据以下规则调整权重和偏置: 其中, 是学习率,控制步长大小。
-
重复以上步骤,直到达到收敛条件(如权重变化很小或达到最大迭代次数)。
4. 优化过程详解
优化过程的目标是找到合适的权重和偏置,使得感知机能够正确分类训练集中的所有样本。具体步骤如下:
a. 初始化
初始化权重向量 和偏置 为零或小随机值。
b. 样本遍历
遍历每个训练样本 :
- 计算感知机输出:
c. 误差计算
检查预测是否正确:
- 如果 ,则不做任何调整。
- 如果 ,则根据以下公式更新权重和偏置:
d. 收敛判断
- 检查权重向量 和偏置 的变化是否在可接受的范围内(即变化很小)。
- 或者,检查是否达到最大迭代次数。
e. 重复
- 如果未达到收敛条件,重复步骤b到d。
5. 数学推导
通过更新规则,我们可以看到,每次更新都会使权重向量和偏置向目标分类方向前进一小步。假设训练集中所有样本线性可分,那么在有限次迭代后,感知机算法将收敛到一个能够正确分类所有样本的解。
6. 感知机的局限性
尽管感知机在处理线性可分数据时表现良好,但它无法处理线性不可分的数据集。例如,XOR问题是经典的感知机无法解决的问题。为了解决这些问题,需要引入更复杂的模型,如多层感知机(MLP)。
7. 示例代码
以下是使用Python实现感知机算法的示例代码:
import numpy as np
class Perceptron: def __init__(self, learning_rate=0.01, n_iters=1000): self.learning_rate = learning_rate self.n_iters = n_iters self.weights = None self.bias = None
def fit(self, X, y): n_samples, n_features = X.shape self.weights = np.zeros(n_features) self.bias = 0
y_ = np.where(y <= 0, -1, 1)
for _ in range(self.n_iters): for idx, x_i in enumerate(X): linear_output = np.dot(x_i, self.weights) + self.bias y_predicted = self._sign(linear_output)
if y_predicted != y_[idx]: update = self.learning_rate * y_[idx] self.weights += update * x_i self.bias += update
def predict(self, X): linear_output = np.dot(X, self.weights) + self.bias y_predicted = self._sign(linear_output) return y_predicted
def _sign(self, x): return np.where(x >= 0, 1, -1)
# 示例数据X = np.array([[1, 1], [2, 2], [3, 3], [4, 4], [1, 0], [0, 1]])y = np.array([1, 1, 1, 1, 0, 0])
# 创建感知机实例perceptron = Perceptron(learning_rate=0.01, n_iters=10)perceptron.fit(X, y)
# 预测predictions = perceptron.predict(X)print("预测结果:", predictions)三、Support Vector Machines
在软间隔支持向量机(Soft-Margin SVM)中,惩罚参数 控制模型对误分类的容忍度。具体来说,参数 决定了优化过程中间隔最大化和误分类最小化之间的权衡。如果惩罚参数 很小,会导致以下结果:
调小Soft-Margin中penalty前面的C
-
更大的间隔:
- 当 很小时,模型更关注于最大化分类间隔(margin),而对误分类点的惩罚较小。这意味着模型会允许更多的误分类,以便找到一个更大的间隔。
- 换句话说,模型倾向于忽略一些训练数据的误分类,以换取更大的决策边界。
-
欠拟合(Underfitting):
- 较小的 值会使模型变得更加平滑,可能无法捕捉数据中的复杂模式。这种情况通常会导致欠拟合。
- 欠拟合的模型对训练数据和测试数据都表现不佳,因为它未能充分学习到数据的特征。
-
更高的训练误差:
- 由于对误分类的惩罚较小,训练误差可能会较高。模型允许更多的训练点落在错误的一侧,从而导致较高的训练误差。
关于Kernal-Function
Kernel function maps low-dimensional data to high-dimensional space:
- 这个说法是正确的。核函数的一个主要功能是通过一种称为“核技巧”(Kernel Trick)的技术,将原始的低维数据隐式地映射到一个更高维的特征空间。在这个高维特征空间中,数据更有可能变得线性可分,从而使线性分类器能够有效地工作。因为non-linear SVM的核心就是将数据升维,然后在更高维的空间中进行区分。但是由于计算难度,最后就直接找两者内积的对应kernal-function,所以kernal function实际上已经将数据升维了。
It’s a similarity function:
- 这个说法也是正确的。核函数本质上是一个衡量相似度的函数。它计算数据点之间的内积,这实际上反映了它们在特征空间中的相似性。例如,常用的高斯核(RBF核)和多项式核都可以视为相似度度量,它们计算两个数据点在特征空间中的距离或相似度。
四、Decision Tree, Ensemble Learning
Decision Tree
为什么用decision tree,因为很多时候类型特征是不方便量化的(比如苹果是红的还是绿的)。Decision Tree具有很好的解释性和泛化性,和我们在现实生活中做分类很像。
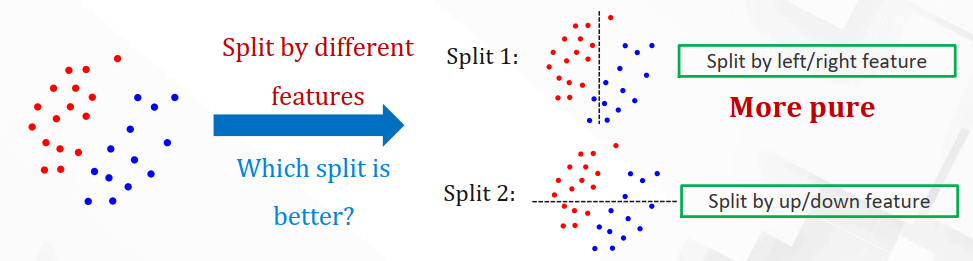
一个很关键的问题:寻找最合适的分类标准
要求 “子节点包含的数据具有纯粹的类别标签” 和 ”可以通过这个特征正确划分“
现有的几种方式:
1、Classification error :
2、Entropy :
3、Gini index :
1、ID3
- 选取分类特征的标准:
采用entropy or information gain作为划分标准。
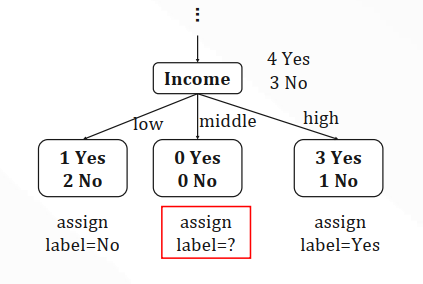
- 遇到Corner Case:
将父节点中最常见的标签指定为目标标签。
- 遇到取值连续的特征:
将原始数据的离散化
2、C4.5
为什么会有C4.5?
信息增益高度偏向于多值特征。比如说日期,每一个日期下面只有一个数据,并且每一个日期类下面的结果很pure,只有下雨或者不下雨一种,对应很高的information gain,但是实际上日期不具备分类价值。
- 解决方案
引入GR:
具有多种可能值的特征往往具有较大的Intrinsic Value。
- 取值连续特征的阈值划分
- 选择阈值为相邻两个值的平均值。
- n 个样本对应 n-1 个阈值。
- 检查 n-1 个阈值,选择 GR 值最大的一个。
Ensemble learning
Bagging
装袋的基本思想:减少单个学习者的差异对于对结果鲁棒性的影响
创建 M 个引导数据集
在每个数据集上训练一个学习器
集合 M 个学习器
对于单个学习模型来说,性能没有提高
Bootstrap Sample
Bagging的基本过程如下:
Bagging的优点:
-
减少方差:多个模型的预测结果通过投票或平均的方式合并,可以有效地减少模型预测的方差,防止过拟合。
-
提高稳定性:由于每个模型都是在略有不同的数据子集上训练,这增加了模型整体的健壮性,使模型对数据中的随机波动不那么敏感。
-
并行计算:由于各个模型的训练是相互独立的,因此Bagging天然适合并行处理,可以有效利用现代计算机的多核处理能力。
**原始数据集中约有 63% 的样本出现在Bagging数据集中。**没有出现的原始数据可以作为Validation Set。
Random Forest
- 创建引导数据集 (Bootstrap Sample)
- 在构建树的过程中,随机抽取 K 个(K<d,可以选择)特征作为每个分割的候选特征。(分类特征的随机性)
如果有一个或几个特征对目标标签有很强的预测作用,那么这些特征就会被选入许多树中,从而导致这些树变得相互关联。(而Bagging的核心思想就是构建很多没有关联的模型,增强模型的鲁棒性)
Boosting
按顺序培训学习者。当前的弱学习者会更多地关注之前的弱学习者分类错误的示例。
1. AdaBoost:For Binary Classification
核心思想:
give higher weights to the misclassified examples
AdaBoost (Adaptive Boosting) 是一个通过逐步增加对错误分类样本的关注来提高分类器性能的算法。其目标是创建一个强分类器,通过组合多个性能较弱的分类器。
算法步骤及公式:
-
初始化权重:
- 对于每个训练样本 ,初始化权重 ,其中 是样本总数。
-
对于 到 :
- 训练一个弱分类器 。
- 计算错误率 ,其中 是指示函数。
- 计算分类器权重 。
- 更新权重 。
- 归一化权重 。
-
构造最终分类器:
-
- 解释:误差率越小,权重就越大,因此分类器的重要性就越高。
伪代码:
输入: 训练数据集 {(x1, y1), ., (xN, yN)}, 弱分类器的数量 M输出: 最终分类器 f(x)
初始化: wi = 1/N for i = 1 to Nfor m = 1 to M do 训练分类器 hm(x) using weights wi 计算错误率 em = sum(wi [yi != hm(xi)]) / sum(wi) 计算分类器权重 αm = log((1 - em) / em) 更新权重 wi = wi * exp(αm [yi != hm(xi)]) 归一化权重 wi = wi / sum(wi)end for返回 f(x) = sign(sum(αm hm(x)))2. Gradient Boosting
核心思想:
Gradient Boosting 是一个用于回归和分类问题的提升技术,通过逐步减少残差来优化任意可微分的损失函数。
算法步骤及公式:
-
初始化模型:
- 用一个常数值 初始化模型,通常 。
-
对于 到 :
- 计算残差 。
- 拟合 至弱学习器 。
- 计算 的系数 。
- 更新模型 ,其中 是学习率。
-
构造最终模型:
伪代码:
输入: 训练数据集 {(x1, y1), ., (xN, yN)}, 弱分类器的数量 M, 损失函数 L输出: 最终模型 F(x)
初始化: F0(x) = argmin γ sum(L(yi, γ))for m = 1 to M do 计算残差 rim = -[∂L(yi, F(xi))/∂F(xi)] at F(x) = Fm-1(x) 拟合 rm 至弱学习器 hm(x) 计算系数 γm = argmin γ sum(L(yi, Fm-1(xi) + γ hm(xi))) 更新模型 Fm(x) = Fm-1(x) + ν γm hm(x)end for返回 F(x) = FM(x)对比Bagging和Boosting
| Bagging | Boosting |
|---|---|
| Parallel ensemble | Sequential ensemble |
| Models are independent | Models are correlated |
| Combine strong models to reduce variance | Combine weak models to primarily reducing bias |
| / | Also less susceptible to overfitting |
Boosting和Deeplearning做对比更好的情况:
➢ 结构化数据(如表格数据) ➢ 训练速度比深度学习算法更快。 ➢ 无需进行复杂超参数调整的小型数据集 ➢ 离散数据 ➢ 高维稀疏数据
XGBoost
正则化:XGBoost在目标函数中引入了正则化项(包括树的叶子节点的数目和叶子节点输出值的L2范数),这有助于控制模型的复杂度,防止过拟合。
五、Learning Theory, Bayesian Decision & Density Estimation
Introduction to Statistical Learning Theory
Empirical Risk Minimization (ERM) 经验风险
模型在训练集 上的平均损失
经验风险最小化(ERM):
该学习算法选择的模型能使训练数据集上的经验风险最小化。
**Population Loss/Expected Risk **:它衡量的是模型在所有可能数据(我们的终极目标!)上的预期性能,而不仅仅局限于训练数据。
Bias-Variance Trade Off
在预测模型中,偏差(Bias)和方差(Variance)是两个重要的概念,它们之间的平衡关系(Bias-Variance Trade-off)对模型的性能有着直接的影响。
-
偏差(Bias):偏差指的是模型在多个不同训练数据集上的平均预测结果与真实目标函数之间的差异。如果一个模型的偏差较高,意味着模型的预测结果与真实结果之间有较大的误差,通常这种情况表明模型过于简化,没有很好地捕捉到数据的复杂性和规律,我们称之为“欠拟合”(underfitting)。
-
方差(Variance):方差描述的是当训练数据集发生变化时,模型预测结果的改变程度。高方差意味着模型对于训练数据非常敏感,如果数据发生微小变化,模型的输出也会产生较大波动。这通常表明模型对训练数据过度敏感或过度复杂,称为“过拟合”(overfitting),在新的、未见过的数据上表现可能会较差。
-
偏差-方差权衡(Bias-Variance Trade-off):在实际应用中,偏差和方差是一对固有的矛盾。通常情况下,降低模型的偏差会使方差增加,反之亦然。这是因为模型需要在足够简单以防止过拟合(低方差)和足够复杂以捕捉数据的真实规律(低偏差)之间找到平衡点。理想的模型是在偏差和方差都相对较低的情况下达到较低的测试误差。
下面进行相关理论计算的推导:
- 预测误差的表示:
这里 是模型在数据集 上对输入 的预测值,而 是真实的目标函数值。
- 引入预测的期望值: 我们可以将 分解为其期望 和该期望值的偏离(即模型预测的方差部分)。所以,预测误差可以重写为:
- 应用平方差公式: 使用 展开上面的表达式,我们得到:
-
分解为方差和偏差:
- 表示预测值相对于其平均(期望)的方差。
- 表示模型预测的平均值与真实值之间的偏差的平方。
-
交叉项: 最后的交叉项 在期望的意义下等于零,因为 的期望为零(即偏离期望的部分的平均是零)。
对于最后的计算结果取期望,相当于得到在输入数据集上的平均效果:
在你的表达式中,通过对所有可能的数据集 取期望,我们可以得到模型预测误差的期望分解。这里,预测误差被分解为两个主要部分:偏差的平方和方差。下面将详细解释这个结果:
偏差的平方
原始的预测误差为 ,通过将其重写并加入期望的概念,我们得到:
Prefer complex model from large hypothesis space ℋ
方差(Variance):
这个部分衡量的是模型在不同数据集上的预测值如何围绕其平均值波动。方差越大,表明模型对数据的依赖性越强,稳定性越差。Prefer smooth model from simple function space ℋ
关键图的分析
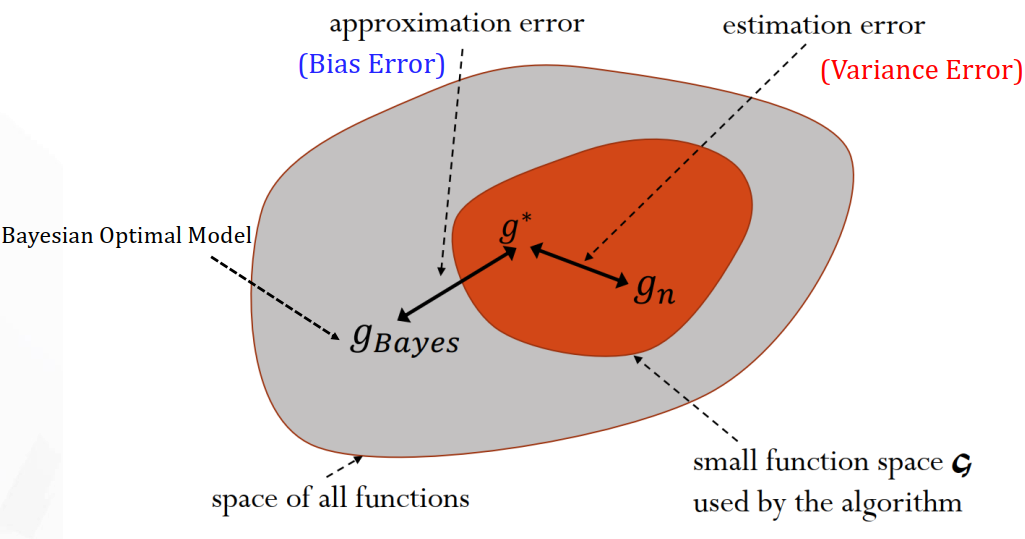
这张图展示了在统计学和机器学习中,一个模型如何通过其函数空间与理想模型(Bayesian Optimal Model)之间的关系来理解偏差与方差。
图中的关键元素
-
总体函数空间(灰色区域):这个区域代表所有可能的函数,即理论上可以表达的所有可能关系。
-
算法使用的函数空间 (橙色区域):这个较小的空间表示特定学习算法能够学习的函数集合。由于实际算法的能力和计算限制,这个空间通常比总体函数空间小。
-
Bayesian Optimal Model :这是理论上的最佳模型,即在所有可能的模型中,平均误差最小的模型。它通常不可达,但是是衡量其他模型性能的基准。
-
真实最佳函数 :在给定算法可达的函数空间 中,最接近 的函数。这是在算法的限制下能达到的最佳预测函数。
-
学习得到的函数 :通过实际训练数据集学习到的函数。这通常会因为数据的限制和随机性而与 存在差异。
解释和分析
-
近似误差(Bias Error):
- 从 到 的距离表示了近似误差,即由于算法能力和函数空间限制造成的误差。这是偏差(Bias)的体现,因为即使是最优化算法在当前模型类中也无法达到Bayesian Optimal Model。
-
估计误差(Variance Error):
- 从 到 的距离表示了估计误差,即由于训练数据的不同而引起的模型性能变化。这是方差(Variance)的体现,表明模型对训练数据的小变化是如何影响最终学习到的函数的。
怎么平衡balance:Regularization
正则化是指用于校准机器学习模型以防止过拟合的技术,它挑选出一小部分更有规律的解子集(惩罚参数的异常行为),以减少方差。 通常,它是通过在损失函数中添加惩罚来实现的:
VC Dimension: Measure Model Complexity
Parametric and Non-Parametric Density Estimation
参数密度估计方法(Parametric Density Estimation Method)是统计学中用于估计数据分布的一种方法。这种方法假设数据来自一个已知形式的概率分布,并通过估计该分布的参数来描述数据的概率密度。以下是对参数密度估计方法的详细介绍:
参数密度估计的基本概念
-
假设已知分布形式:
- 参数密度估计方法假设数据样本来自某个已知形式的概率分布(例如正态分布、指数分布等)。这种假设使得我们只需要估计分布的参数,而不是整个分布。
-
估计分布的参数:
- 给定一个样本数据集,通过统计方法(例如最大似然估计或贝叶斯估计)来估计该分布的参数。
常见的参数密度估计方法
-
正态分布(Normal Distribution):
- 假设数据服从正态分布 ,其中 是均值, 是方差。
- 参数估计:
- 均值 的估计:
- 方差 的估计:
-
指数分布(Exponential Distribution):
- 假设数据服从指数分布 ,其中 是参数。
- 参数估计:
- 参数 的估计: ,其中 是样本均值。
-
泊松分布(Poisson Distribution):
- 假设数据服从泊松分布 ,其中 是事件发生的平均速率。
- 参数估计:
- 参数 的估计:
参数估计方法
-
最大似然估计(Maximum Likelihood Estimation, MLE):
-
MLE方法通过最大化样本数据在假设分布下的似然函数来估计分布参数。
-
例如,对于正态分布,似然函数为:
-
通过对数似然函数取对数并求导,得到参数的估计值。2. 贝叶斯估计(Bayesian Estimation):
-
贝叶斯估计通过结合先验分布和似然函数,得到参数的后验分布。
-
例如,对于正态分布的均值参数 ,如果先验分布为 ,则后验分布为:
- 贝叶斯方法提供了参数估计的不确定性信息。
优缺点
优点:
- 简洁:参数密度估计方法通过少量参数描述数据分布,模型简洁易理解。
- 高效:估计参数所需计算量较小,适用于大规模数据集。
缺点:
- 依赖假设:参数密度估计方法依赖于对数据分布形式的假设。如果假设不正确,估计结果会有偏差。
- 灵活性不足:对于复杂分布或多峰分布,参数密度估计方法可能无法有效描述。
应用场景
参数密度估计方法广泛应用于各类统计分析和机器学习任务中,例如:
- 数据建模:对数据进行概率建模,描述数据生成过程。
- 假设检验:检验数据是否符合特定分布。
- 预测分析:基于估计的分布进行概率预测和风险评估。
非参数密度估计的基本概念
-
不假设特定分布形式:
- 与参数密度估计不同,非参数方法不假设数据来自某种已知形式的概率分布。这使得非参数方法在面对未知或复杂分布时具有更高的适应性。
-
直接估计密度函数:
- 非参数方法直接从数据中估计密度函数,常见的方法包括直方图、核密度估计(KDE)和k近邻密度估计(k-NN Density Estimation)。
常见的非参数密度估计方法
-
直方图(Histogram):
-
直方图是最简单的非参数密度估计方法,通过将数据分割成若干个等宽的区间(bin),计算每个区间内的数据点数量来估计密度。
-
直方图的密度估计公式:
-
其中 $h$ 是bin的宽度,$I$ 是指示函数。2. 核密度估计(Kernel Density Estimation, KDE):
-
核密度估计是一种平滑的非参数方法,通过在每个数据点上放置一个核函数,并对所有核函数进行加权平均来估计密度。
-
KDE的密度估计公式:
其中 $K$ 是核函数(如高斯核),$h$ 是带宽(平滑参数)。-
核函数常见选择:
- 高斯核:
- 其他核函数:均匀核、三角核等。
-
k近邻密度估计(k-Nearest Neighbors Density Estimation):
-
k近邻密度估计通过在给定点附近找到k个最近邻点,根据这些邻点的密度来估计给定点的密度。
-
k-NN密度估计公式:
-
其中 $V_k(x)$ 是包含第k个最近邻点的球体积。非参数密度估计的优缺点
优点:
- 灵活性高:非参数方法不假设数据分布形式,能够适应多种复杂数据结构。
- 捕捉细节:非参数方法能够捕捉数据的局部特征和细节,如多峰分布。
缺点:
- 计算成本高:非参数方法通常计算量较大,尤其是对于大规模数据集。
- 选择参数敏感:如带宽(KDE)和邻居数量(k-NN)的选择对估计结果影响较大,需谨慎选择。
应用场景
非参数密度估计方法广泛应用于统计分析和机器学习的各个领域,包括:
- 数据探索:对数据进行初步探索和可视化,了解数据的分布特征。
- 异常检测:基于密度估计发现数据中的异常点。
- 模式识别:在无监督学习中用于识别数据的潜在模式和结构。
- 概率预测:在没有明确分布假设的情况下进行概率预测和风险评估。
示例
核密度估计(KDE)示例
假设我们有一组一维数据 ,希望估计其概率密度函数。
-
选择核函数和带宽:
- 常用核函数:高斯核
- 选择带宽
-
计算密度估计:
-
绘制密度估计曲线:
- 计算不同 值对应的密度估计
- 绘制 对 的曲线图
通过以上步骤,可以得到数据的平滑密度估计曲线,反映数据的分布情况。
非参数密度估计方法在处理复杂和未知分布的数据时非常有效,是统计分析和数据科学中的重要工具。
Bayes Networks, Hidden Markov Mode
引入
区分性模型(Discriminative Models)
区分性模型用于直接学习输入数据和输出标签之间的决策边界。常见的区分性模型包括:
- 逻辑回归(Logistic Regression):
- 用于二分类或多分类问题,模型学习数据点属于某个类别的概率。
- 支持向量机(Support Vector Machines, SVM):
- 用于二分类或多分类问题,通过寻找最大化分类边界的超平面来区分数据点。
- 决策树(Decision Trees):
- 通过递归地将数据集分割成更小的子集,形成树形结构,用于分类和回归任务。
生成性模型(Generative Models)
生成性模型用于学习数据的生成过程,可以生成新的数据点。常见的生成性模型包括:
- 隐马尔可夫模型(Hidden Markov Models, HMM):
- 一种用于处理序列数据的统计模型,假设系统的未来状态只依赖于当前状态,观测数据与隐藏状态相关联。
- 应用领域:语音识别、自然语言处理、生物信息学等。
- 贝叶斯网络(Bayesian Networks):
- 一种用于表示变量之间的条件依赖关系的有向无环图(DAG),可以用于推理和决策。
- 应用领域:故障诊断、医疗诊断、预测和决策支持等。
- 变分自编码器(Variational Autoencoders, VAE):
- 一种生成模型,通过将输入数据编码为潜在变量,再从潜在空间中采样并解码生成数据。
- 应用领域:图像生成、数据压缩、异常检测等。
- 生成对抗网络(Generative Adversarial Networks, GAN):
- 通过两个网络(生成器和判别器)之间的对抗训练,生成与真实数据分布相似的数据。
- 应用领域:图像生成、图像修复、风格迁移等。
二者对比:生成模型仍可执行判别任务
| 区分型模型: | 生成式模型 |
|---|---|
| 只能对现有数据实例进行分类或预测。 只能学习输入和输出之间的相关性。 无法处理缺失数据。 | 生成符合数据分布的新样本。 捕捉数据的潜在结构和因果因素。 可从部分观测数据中推断缺失数据 |
在生成式模型(Generative Models)中,联合分布和边际分布是两个重要的概念,理解它们有助于掌握生成式模型的基本原理和应用。下面详细解释这两个概念:
联合分布(Joint Distribution)
定义:
- 联合分布 表示变量 和 同时取特定值的概率。
- 这里, 是模型的参数。
解释:
- 在生成式模型中,联合分布描述了整个系统的全貌,即如何生成数据 和标签 (或隐变量)。
- 对于一个给定的生成式模型,我们通常会建模 和 的联合分布,以便能够从中生成新的样本对。
公式:
- 联合分布可以分解为条件分布和边际分布的乘积:
或者:
其中, 是在给定 的情况下 的条件分布, 是在给定 的情况下 的条件分布, 和 是边际分布。
边际分布(Marginal Distribution)
定义:
- 边际分布 是联合分布 对 的边际化(积分或求和)结果。
- 它表示变量 取特定值的概率,忽略了 的影响。
解释:
- 边际分布反映了生成模型中变量 的整体分布情况,而不考虑其他变量(如 )。
- 在生成式模型中,边际分布 可以用于生成新的数据样本 。
公式:
- 对于离散变量,边际分布是联合分布对所有可能的 值求和得到的:
- 对于连续变量,边际分布是联合分布对 进行积分得到的:
应用示例
- 变分自编码器(Variational Autoencoders, VAE)
在VAE中,我们感兴趣的是如何生成数据 。我们通过隐变量 的联合分布建模生成过程。
- 联合分布:
- 边际分布:
在训练过程中,我们通过优化变分下界(ELBO)来近似求解 ,使得模型能够生成与训练数据分布相似的新数据点。
- 生成对抗网络(Generative Adversarial Networks, GAN)
在GAN中,我们通过对抗训练来使生成器能够生成逼真的数据样本 。
- 联合分布: ,其中 是随机噪声。
- 边际分布:
生成器学习从噪声 生成数据 ,从而逼近真实数据分布 。
总结
- 联合分布 :描述了变量 和 的联合概率,全面反映系统的生成机制。
- 边际分布 :通过对联合分布进行边际化得到,只描述变量 的概率分布,常用于生成新的数据样本。
理解联合分布和边际分布在生成式模型中的作用,有助于更好地掌握生成式模型的工作原理和应用场景。
Hidden Markov Models (HMMs)
First-Order Markov Chain
定义
一阶马尔可夫链是一种时间序列模型,其特征是当前时间步的值仅依赖于前一个时间步的值,而不依赖于更早之前的值。形式化地说,对于一个时间序列 ,如果满足以下条件,则称为一阶马尔可夫链:
也就是说,在给定 的条件下, 与之前的所有值 条件独立。
转移概率(Transition Probability)
转移概率描述了从一个状态到另一个状态的概率。在一阶马尔可夫链中,转移概率可以表示为:
其中, 表示从状态 转移到状态 的概率。
联合概率分布
对于一阶马尔可夫链,联合概率分布可以分解为初始状态的概率和一系列转移概率的乘积。具体来说,给定序列 ,其联合概率分布可以表示为:
公式解释
-
初始状态概率 :
- 这是时间序列的起始点 的概率。
-
条件概率 :
- 这是在给定前一个状态 的条件下,当前状态 的概率。
-
联合概率分布的展开:
- 通过将初始状态的概率与各个时间步的条件概率相乘,得到整个时间序列的联合概率分布。
隐马尔可夫模型的三个任务
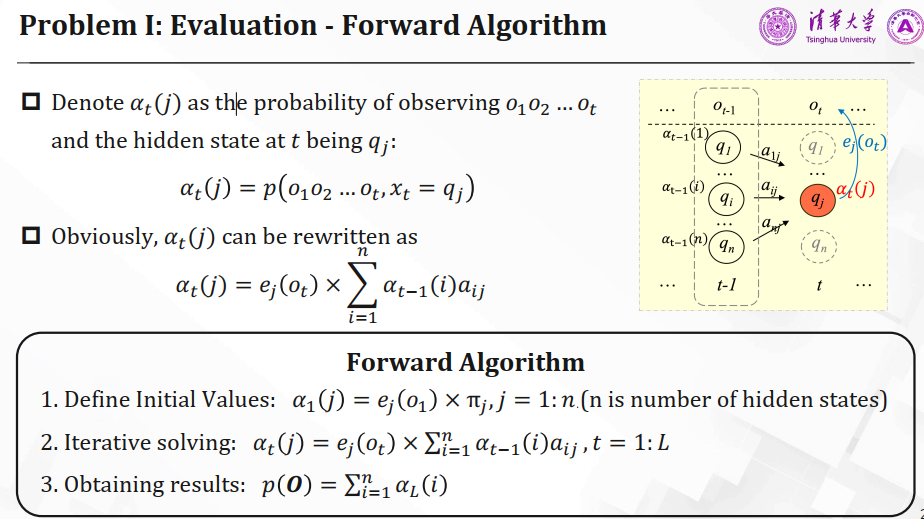
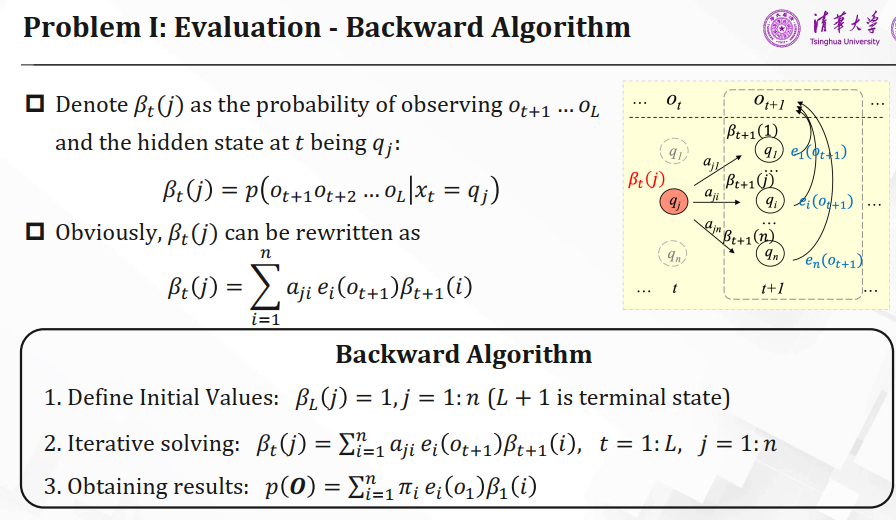
1、HMM 的评估问题:给定模型和观测序列,计算观测序列的概率。
If hidden state sequence is known: Then, the joint probability is The likelihood of observing sequence can be obtained by marginalizing over
| Forward Algorithm | Backward Algorithm |
|---|---|
 |  |
2、HMM 中的解码问题:给定模型和观测序列,计算最可能的隐藏状态序列。
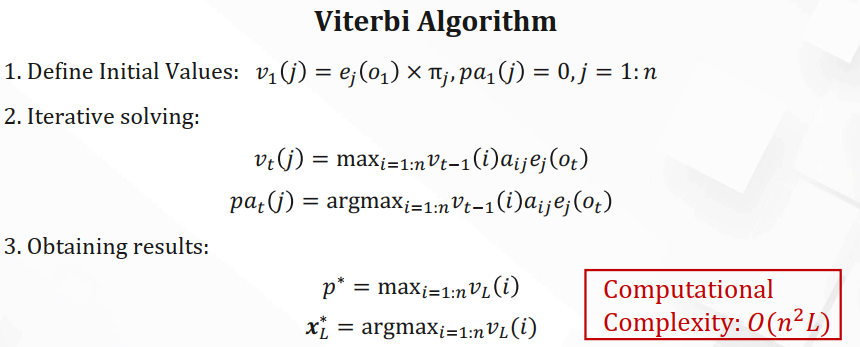
3、在隐马尔可夫模型(Hidden Markov Model, HMM)中,学习问题的核心是根据观测序列来估计模型的参数。具体来说,我们希望找到使得观测序列概率最大的模型参数。这个问题可以形式化为以下优化问题:
学习 - Baum-Welch算法
- 已知隐藏状态序列时的参数估计
如果已知隐藏状态序列,可以通过计数来直接估计转移矩阵 的参数:
其中, 表示从状态 转移到状态 的次数, 表示从状态 转移到任何状态的总次数。
然而,通常情况下,隐藏状态 是未知的,因此无法直接计数 。
Baum-Welch算法
Baum-Welch算法通过E步和M步来迭代优化模型参数:
-
期望步骤(E步):使用当前参数 和观测到的数据估计(猜测)缺失数据的值。
-
最大化步骤(M步):使用E步生成的完整数据来更新模型参数。
详细步骤
假设训练样本由长度为 的单个序列组成。
- 初始化
初始化模型参数 。这些初始值可以是随机的或通过其他方法估计的。
- 期望步骤(E步)
计算在当前参数 下观测序列的隐含变量的期望值,包括前向概率、后向概率和联合概率。
-
前向概率 :
- 计算从初始状态到时刻 的状态 的概率:
-
后向概率 :
- 计算从时刻 的状态 出发,到序列结束的观测概率:
-
联合概率 :
- 计算在时刻 处于状态 且在时刻 处于状态 的联合概率:
-
单状态概率 :
- 计算在时刻 处于状态 的概率:
- 最大化步骤(M步)
使用期望步骤计算的期望值来更新模型参数。
-
更新初始概率分布 :
- 更新初始状态的概率:
-
更新转移概率矩阵 :
- 更新从状态 到状态 的转移概率:
-
更新发射概率矩阵 :
- 更新在状态 下观测到符号 的概率:
- 迭代
重复E步和M步,直到模型参数收敛或达到预定的迭代次数。
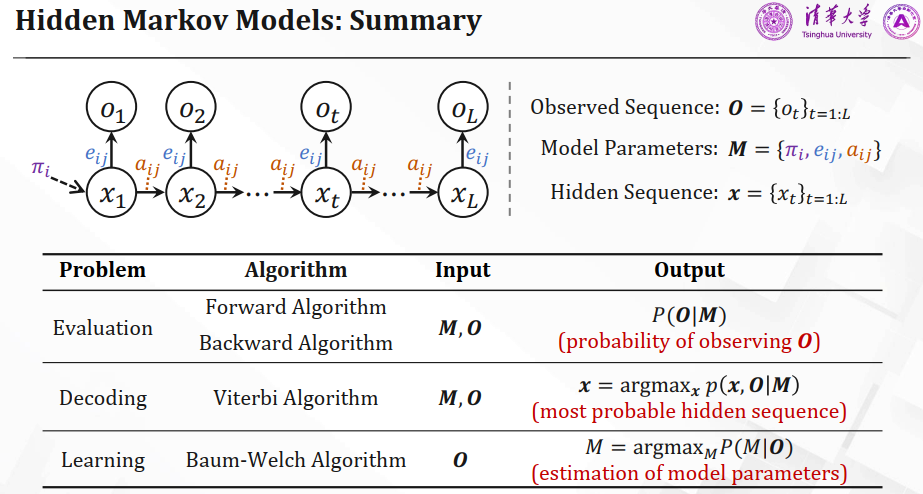
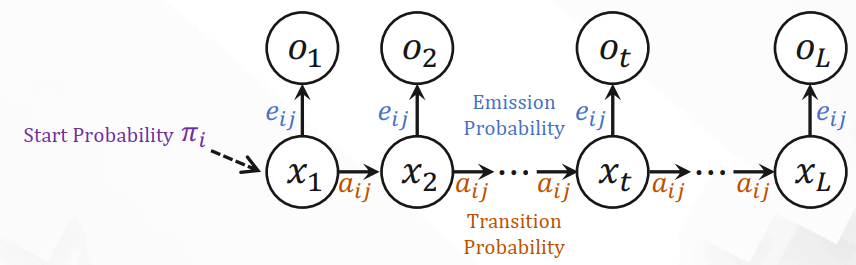
隐马尔可夫模型(HMM): 我们从不观察内部状态。我们只能观察取决于内部状态的输出
Bayes Network
朴素贝叶斯分类器是一种基于贝叶斯定理的简单而强大的概率分类算法。它在文本分类、垃圾邮件过滤、情感分析等任务中广泛应用。
主要概念
贝叶斯定理
贝叶斯定理描述了后验概率(在观察到数据后某一假设为真的概率)与先验概率(假设为真的初始概率)之间的关系。公式如下:
其中:
- 是在事件 发生的条件下,事件 发生的概率(后验概率)。
- 是在事件 发生的条件下,事件 发生的概率(似然)。
- 是事件 发生的概率(先验概率)。
- 是事件 发生的概率。
朴素假设
朴素贝叶斯分类器之所以称为“朴素”,是因为它假设特征之间是条件独立的。即在给定类别的条件下,每个特征的出现都是独立的。虽然这一假设在实际应用中并不总是成立,但它使得计算变得简单且有效。
朴素贝叶斯分类器的公式
给定一个特征向量 和类别 ,朴素贝叶斯分类器将特征向量分类到类别 的决策规则是选择使后验概率 最大的类别:
根据贝叶斯定理,后验概率 可以表示为:
由于 对于所有类别 都是常数,可以简化为:
在朴素假设下,特征之间相互独立,因此:
最终分类决策规则变为:
应用步骤
-
训练阶段:
- 计算每个类别的先验概率 。
- 计算在每个类别条件下,每个特征的条件概率 。
-
预测阶段:
- 对于每个待分类的样本,计算其在每个类别下的后验概率 。
- 选择后验概率最大的类别作为预测结果。
示例
假设有一个简单的垃圾邮件过滤器,根据邮件中的特征(如是否包含某个词语)来判断邮件是否为垃圾邮件。我们有以下训练数据:
| 邮件内容(特征) | 类别 |
|---|---|
| ”免费”、“优惠”、“点击” | 垃圾邮件 |
| ”会议”、“报告”、“日程” | 正常邮件 |
| ”优惠”、“报告”、“点击” | 垃圾邮件 |
| ”免费”、“会议”、“日程” | 正常邮件 |
训练阶段计算每个类别的先验概率和条件概率:
假设我们有一个待分类的邮件包含特征:“免费”、“优惠”、“点击”。
计算该邮件为垃圾邮件和正常邮件的后验概率:
选择后验概率最大的类别作为预测结果。
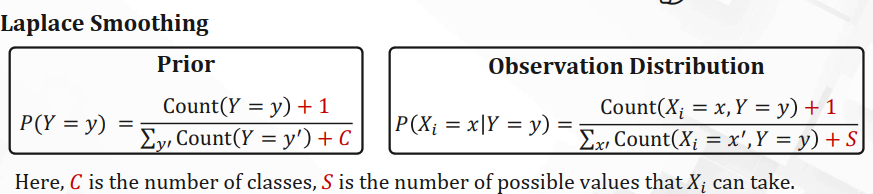
Laplace Smoothing
When the number of samples are small, it is likely to encounter cases where
七、Unsupervised Learning - Clustering
K-means 聚类算法
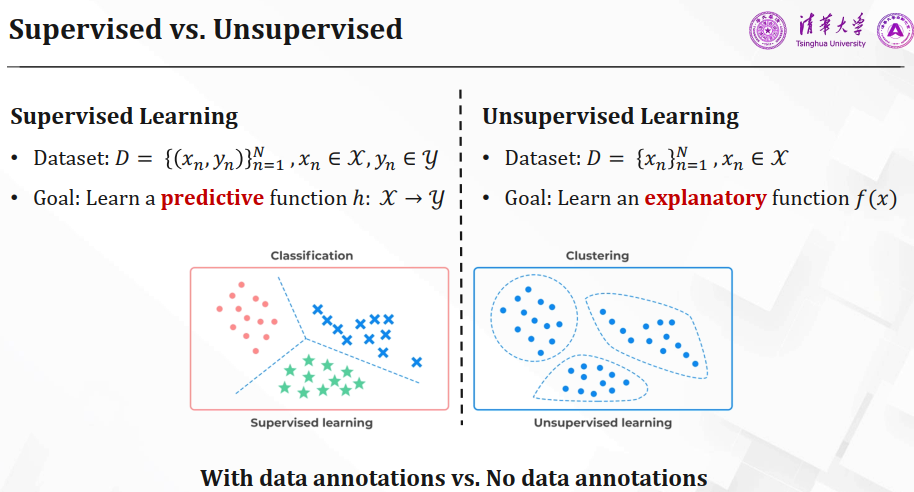
K-means 聚类是一种常见的无监督学习算法,广泛用于数据挖掘、图像处理和模式识别等领域。该算法通过迭代优化目标函数,将数据点分配到 个聚类中心,使得同一个聚类内的数据点尽可能接近,而不同聚类的数据点尽可能远离。
算法步骤
-
初始化聚类中心:
- 随机选择 个数据点作为初始的聚类中心 。
-
重复以下步骤,直到聚类分配不再改变:
-
分配步骤(Assignment step):
-
将每个数据点分配到离它最近的聚类中心。
-
数学表达式为:对于每个数据点 ,找到最近的聚类中心 ,使得:
-
-
- 简单来说,就是计算每个数据点到所有聚类中心的距离,并将数据点分配给最近的聚类中心。2. 更新步骤(Update step):
- 更新每个聚类的中心为分配给该聚类的所有数据点的均值。
- 数学表达式为:对于每个聚类中心 $\mu_k$,更新其位置为: - 这一步骤的目的是通过计算均值来重新定位聚类中心,使其更接近当前聚类内的所有数据点。算法收敛
- K-means 算法通过不断迭代上述两个步骤,最终达到收敛状态,即聚类分配不再改变。
- 算法的收敛性通常较快,但最终结果可能依赖于初始聚类中心的选择。因此,常常需要多次运行 K-means 算法,并选择最优的聚类结果。
优缺点
-
优点:
- 简单且容易实现。
- 计算速度快,适用于大规模数据集。
- 在聚类数 固定的情况下,算法的复杂度为 ,其中 为数据点的数量, 为迭代次数。
-
缺点:
- 需要预先指定聚类数 。
- 对初始聚类中心敏感,不同的初始选择可能导致不同的聚类结果。
- 适用于球状聚类,对形状复杂的聚类效果较差。
- 可能收敛到局部最优解,而非全局最优解。
怎么确定要聚成几簇
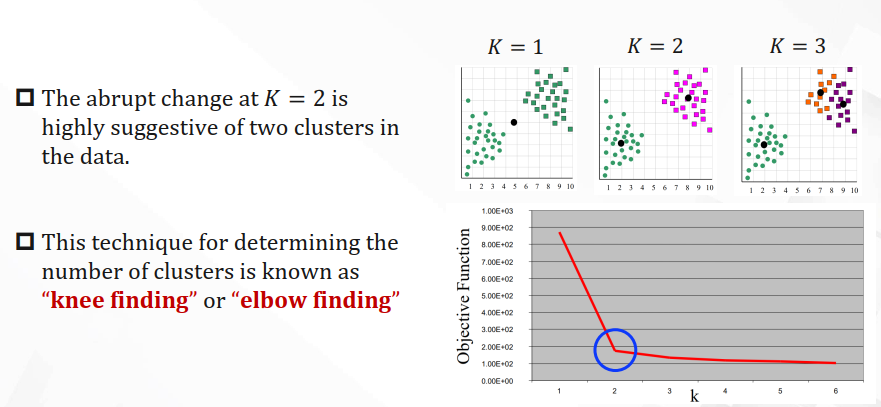
对于其他距离度量方式。选择合适地centroid可能会变得很复杂。不是简单地平均
EM Algorithm for GMM
EM 算法在高斯混合模型(GMM)中的应用
概述
高斯混合模型(Gaussian Mixture Model, GMM)是一种概率模型,用于表示具有多个高斯分布的混合体。EM算法(Expectation-Maximization Algorithm)是一种迭代优化算法,用于在存在潜在变量的情况下,找到模型参数的最大似然估计。GMM 中的 EM 算法通过交替执行期望步骤(E步)和最大化步骤(M步)来估计参数。
具体步骤
-
初始化:
- 随机初始化每个高斯分布的参数:均值()、协方差矩阵()和混合系数()。
-
期望步骤(E-step):
- 计算每个数据点属于每个高斯分布的后验概率(即责任度)。
- 这里, 表示数据点 在第 个高斯分布下的概率密度函数。
-
最大化步骤(M-step):
-
更新模型参数,使得在当前责任度下对数似然函数最大化。
-
更新混合系数:
-
其中,$N_k = \sum_{n=1}^{N} \gamma_{nk}$ 是第 $k$ 个高斯分布的有效样本数。- 更新均值:
- 更新协方差矩阵:
-
重复:
- 重复执行 E 步骤和 M 步骤,直到对数似然函数的增量小于预设阈值或者达到最大迭代次数。
图示说明
-
硬聚类(Hard Clustering):
- 每个数据点只能属于一个聚类。
- 例如K-means算法,每个点被分配到最近的聚类中心。
- 缺点:在数据自然形成重叠聚类或不规则形状时效果不好。
-
软聚类(Soft Clustering):
- 每个数据点可以以某个程度属于多个聚类。
- 例如模糊C均值(Fuzzy C-means)算法,每个点对所有聚类中心有不同的隶属度。
-
概率聚类(Probabilistic Clustering):
- 每个数据点分配一个概率分布,表示其属于每个聚类的概率。
- 例如高斯混合模型(GMM),每个点的概率分布是多个高斯分布的混合。
GMM与EM算法的优点
- 柔性强:可以处理形状复杂、重叠的聚类。
- 概率解释:提供数据点属于某个聚类的概率,适合不确定性较高的数据分析。
- 模型选择:通过比较不同混合成分数量的模型的似然,可以进行模型选择。
知识补充
多维高斯分布和协方差矩阵示例
多维高斯分布(也称为多元正态分布)是高斯分布的扩展,它用于描述多维数据集。协方差矩阵()是多维高斯分布的重要参数之一,它描述了数据的分布情况及变量之间的线性关系。
多维高斯分布的定义
一个 维的高斯分布可以用以下参数来描述:
- 均值向量 (长度为 的向量)
- 协方差矩阵 ( 的矩阵)
多维高斯分布的概率密度函数为:
其中, 是协方差矩阵的行列式, 是协方差矩阵的逆矩阵。
示例
示例 1:二维高斯分布
- 均值向量:
- 协方差矩阵:
在这个示例中,协方差矩阵表示两个变量之间的关系:
- 对角线上的元素(1和1)是各个变量的方差,表示变量自身的分布范围。
- 非对角线上的元素(0.5和0.5)是两个变量之间的协方差,表示它们之间的线性关系。
示例 2:三维高斯分布
- 均值向量:
- 协方差矩阵:
在这个三维示例中,协方差矩阵描述了三个变量之间的关系:
- 对角线上的元素(1, 2, 1)是每个变量的方差。
- 非对角线上的元素(例如0.3、0.2等)是不同变量之间的协方差,表示它们之间的线性关系。
协方差矩阵的解释
-
对角线元素(方差):
- 协方差矩阵的对角线元素表示各个变量的方差。方差越大,变量的分布范围越广。
- 例如,在二维示例中,变量1的方差是1,变量2的方差也是1。
-
非对角线元素(协方差):
- 协方差矩阵的非对角线元素表示变量之间的协方差。协方差表示两个变量之间的线性关系:
- 正协方差:当一个变量增加时,另一个变量也倾向于增加。
- 负协方差:当一个变量增加时,另一个变量倾向于减少。
- 零协方差:两个变量之间没有线性关系。
- 例如,在二维示例中,两个变量之间的协方差是0.5,表示它们有正相关关系。
- 协方差矩阵的非对角线元素表示变量之间的协方差。协方差表示两个变量之间的线性关系:
GMM做数据生成
1. 多个高斯分布的集合
考虑有 个高斯分布的集合,每个高斯分布有不同的均值和协方差矩阵:
这些分布被称为高斯成分。
2. 数据点的生成
假设数据点 是由上述 个高斯分布中的一个生成的。选择是哪个高斯分布服从 的分布。
- 具体步骤:
- 首先,从 个高斯分布中随机选择一个。
- 然后,从选定的高斯分布中生成数据点 。
3. 隐变量
定义一个离散随机变量 ,其取值范围为 。该变量表示生成数据点 的高斯分布的身份。
这意味着如果 的取值为 ,那么数据点 是从第 个高斯分布生成的。
4. 数据点的条件概率
给定 的取值,数据点 的条件概率为:
这表示在已知 是由第 个高斯分布生成的条件下, 的概率密度函数是一个均值为 、协方差矩阵为 的高斯分布。
5. 隐变量
变量 被称为隐变量,因为它的取值通常是不可观测的。在实际应用中,我们只能观测到数据点 ,而不能直接观测到生成 的具体高斯分布 。
举例说明
假设我们有三个高斯分布:
数据点 的生成过程如下:
- 随机选择一个高斯分布。例如,假设选择了第一个高斯分布 。
- 从该高斯分布中生成数据点 。
在这个过程中,离散随机变量 的取值为 1,因为我们选择了第一个高斯分布。给定 ,数据点 的条件概率为:
总结
- 高斯混合模型(GMM):通过多个高斯分布的混合来表示数据点的生成。
- 隐变量 :表示生成数据点的具体高斯分布的身份,通常不可观测。
- 数据点的条件概率:在已知生成数据点的高斯分布的条件下,数据点 的概率密度函数是该高斯分布的概率密度函数。
高斯混合模型通过对隐变量 的引入和对数据点 的条件概率进行建模,能够有效地捕捉数据的复杂分布结构。
GMM的学习
要理解高斯混合模型(GMM, Gaussian Mixture Model)的分布及其学习过程,需分为以下几个步骤:
1. 高斯混合模型的基本概念
高斯混合模型是由多个高斯分布组成的加权和,用来描述数据的分布。GMM假设数据是由多个不同的高斯分布混合生成的,每个高斯分布代表一个潜在的类别。GMM的概率密度函数可以表示为:
其中:
- 是高斯分布的数量。
- 是第 个高斯分布的权重,且 。
- 是第 个高斯分布的概率密度函数,具有均值 和协方差矩阵 。
2. 高斯混合模型的参数估计
GMM的参数包括每个高斯分布的均值 、协方差矩阵 以及各个分布的权重 。这些参数通常通过期望最大化(EM, Expectation-Maximization)算法来估计。
期望最大化算法的步骤
-
初始化参数:
- 初始化每个高斯分布的均值 、协方差矩阵 以及权重 。可以随机初始化,也可以使用K-means聚类结果作为初始值。
-
E步(Expectation Step):
- 计算每个样本 属于每个高斯分布的后验概率(责任度) ,即第 个样本由第 个高斯分布生成的概率:
-
M步(Maximization Step):
- 更新参数,使得似然函数最大化。新的参数更新公式如下:
-
重复步骤2和步骤3,直到参数收敛或达到最大迭代次数。
对比
| K-Means (Hard Clustering) | EM Algorithm (Soft Clustering) |
|---|---|
| Assignment Variable | Responsibility |
| belong to the -th cluster}$ | = Probis generated by the-th component}$ |
| Assignment Step | E-step |
\gamma_{n,k} = p(z_n = 1(原笔记待补全) | |
| Update Step | M-Step |
两者之间的相互转化:
- 协方差矩阵固定: 假设GMM中的每个高斯分布的协方差矩阵取固定值 ,其中 ,并且 是一个常数, 是单位矩阵。
- 当 时: 当 逐渐趋近于零,责任度 会变成:
其中 。
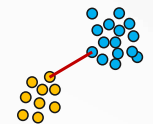
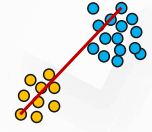
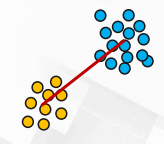
Hierarchical Clustering
在聚类分析中,常见的方法有划分聚类(Partitional Clustering)和层次聚类(Hierarchical Clustering)。这两种方法各有特点和适用场景。下面是它们的对比:
划分聚类(Partitional Clustering)
定义:划分聚类将数据集直接分成若干不重叠的簇,每个簇代表一个类别。常见的划分聚类方法包括K-means、K-medoids等。
特点:
- 簇的数量:用户需要预先指定簇的数量 。
- 迭代优化:通常通过迭代优化某个目标函数(如K-means中的最小化簇内平方误差)来得到最终的聚类结果。
- 效率:对于大规模数据集,划分聚类方法通常更高效。
- 初始值敏感:聚类结果可能对初始中心点选择敏感,不同的初始点可能导致不同的结果。
优点:
- 计算效率高,适用于大数据集。
- 结果易于解释。
缺点:
- 需要预先指定簇的数量。
- 对初始值和参数敏感。
层次聚类(Hierarchical Clustering)
定义:层次聚类通过构建一个层次结构(树形结构)来表示数据的聚类关系。层次聚类可以分为自底向上(凝聚型)和自顶向下(分裂型)两种类型。
特点:
- 不需要预先指定簇的数量:层次聚类不需要用户预先指定簇的数量,簇的数量可以在后续通过剪切树状图(dendrogram)来确定。
- 树状结构:聚类结果以树状结构展示,能够显示数据的多级嵌套关系。
- 可解释性强:通过树状图,可以清晰地看到数据之间的层次关系。
优点:
- 不需要预先指定簇的数量。
- 能够展示数据的层次关系。
- 结果对不同距离度量方法和链接方法(如单链接、完全链接、平均链接等)较为稳健。
缺点:
- 计算复杂度高,尤其是对大规模数据集。
- 对噪声和离群点敏感。
对比总结
| 特点 | 划分聚类 | 层次聚类 |
|---|---|---|
| 簇的数量 | 需要预先指定 | 不需要预先指定 |
| 结构展示 | 平面分割 | 树状层次结构 |
| 计算效率 | 高效,适用于大数据集 | 计算复杂度高,适用于小数据集 |
| 初始值敏感性 | 敏感 | 不敏感 |
| 对噪声和离群点的敏感性 | 较低 | 高 |
| 典型算法 | K-means, K-medoids | 凝聚层次聚类, 分裂层次聚类 |
在实际应用中,选择哪种聚类方法取决于具体的数据特征和分析需求。如果数据规模较大且已知簇的数量,可以选择划分聚类;如果希望了解数据的层次结构或者簇的数量不明确,可以选择层次聚类。
层次聚类的分类
| 特性 | Bottom-Up (Agglomerative) | Top-Down (Divisive) |
|---|---|---|
| 聚类方法 | 从每个项目开始,各自形成一个簇,找到最佳对合并到新的簇中。 | 从一个包含所有项目的簇开始,考虑将其分成两个簇的所有可能方式。 |
| 聚类过程 | 反复操作直到所有簇融合在一起。 | 选择最佳分割,并递归地在两边继续操作。 |
| 计算复杂度 | 通常更高,因为需要反复计算所有可能的对。 | 可能更低,尤其是当可以快速找到好的分割点时。 |
| 适用场景 | 更适合于数据量较小或簇数量预先未知的情况。 | 更适合于数据量较大且簇数量大致可预见的情况。 |
| 初始状态 | 每个项目各自为一个簇。 | 所有项目合为一个簇。 |
| 合并/分割操作的依据 | 合并操作依据于相似度(距离)矩阵,选择最相似的两个簇进行合并。 | 分割操作依据于簇内差异性,选择使得簇内差异性最小的分割方式。 |
| 主要优点 | 直观易懂,适合多种类型的数据。 | 高效处理大数据集,能够发现大型簇中的细微结构。 |
| 主要缺点 | 随数据量增加,计算复杂度急剧上升。 | 需要预先选择分割方式,可能对初始选择较为敏感。 |
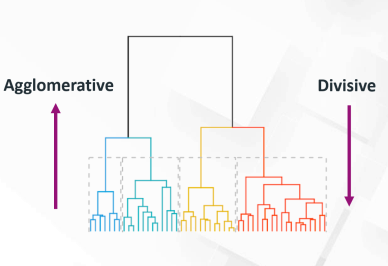
关于Bottom-Up (Agglomerative)的详细介绍
输入参数:
- d: 簇间距离度量
- X: 数据集,表示为
- k: 最终所需的簇的数量
初始化:
- : 每个数据点单独形成一个簇
迭代过程:
- 找到最近的簇对 基于距离度量 :
- 这一步找出在当前簇集合中距离最近的两个簇。
- 合并选择的簇 和 :
- 将找到的最近簇对合并成一个新的簇。
- 更新簇集合 :
- 从簇集合中移除原来的两个簇 和 ,并加入新的簇 。
终止条件:
- 当簇的数量达到预定的数量 时停止。
复杂度分析:
- 空间复杂度:
- 需要存储簇之间的距离矩阵,矩阵大小为 。
- 时间复杂度:
- 每次合并簇时都需要找到最近的簇对,这需要计算所有簇对之间的距离,重复 次。
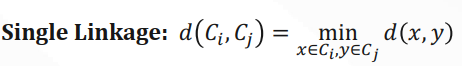 | 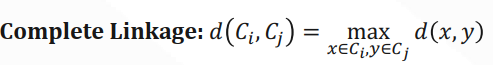 | 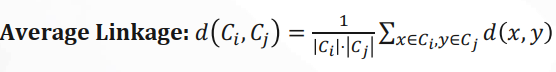 |
|---|---|---|
 |  |  |
Spectral Clustering and Others
Clustering by graph is needed when dealing with datasets that exhibit complex structures or non-convex shapes.
图拉普拉斯算子的性质与推导
命题
对于任意向量 ,我们有:
归一化的拉普拉斯算子 也满足类似的性质:
推导过程
这里只证明 的情况, 的推导类似。
-
开始公式:
-
展开:
其中 是节点 的度数(即与节点 相连的边的权重之和)。
- 代入公式:
- 重新组合:
于是,
- 合并两项: 观察到
可以重新组合成
- 重组和简化:
这可以简化为
因此,我们得到了所需的结果:
归一化拉普拉斯 的推导
归一化的拉普拉斯算子 的推导过程类似,只是引入了度的归一化因子:
这个推导步骤和上面类似,重点在于每一步将 替换为 ,并进行相同的重新组合和简化。
性质
-
半正定性(Semi-Positive Definiteness):
- 和 是半正定的(semi-positive definite)。
证明:
- 根据前一个命题,对于任意向量 ,我们有: 因为权重 且平方项 ,因此整个和不小于0。
-
最小特征值:
- 和 的最小特征值是0,对应的特征向量是 。
证明:
- 对于拉普拉斯矩阵 :
其中 $\mathbf{1}$ 是全1向量。
展开计算: 由于 $d_i = \sum_{j=1}^n W_{ij}$,我们有: 因此,我们得到: 即,0 是 $L$ 的特征值,对应的特征向量是 $\mathbf{1}$。- 对于归一化拉普拉斯矩阵 :
因此, 即,0 是 $L'$ 的特征值,对应的特征向量也是 $\mathbf{1}$。总结
- 拉普拉斯矩阵 和归一化拉普拉斯矩阵 都是半正定的。
- 它们的最小特征值是0,对应的特征向量是 ,这表明图的连通性。
- 证明过程主要利用了拉普拉斯矩阵的定义及其行和为零的性质。
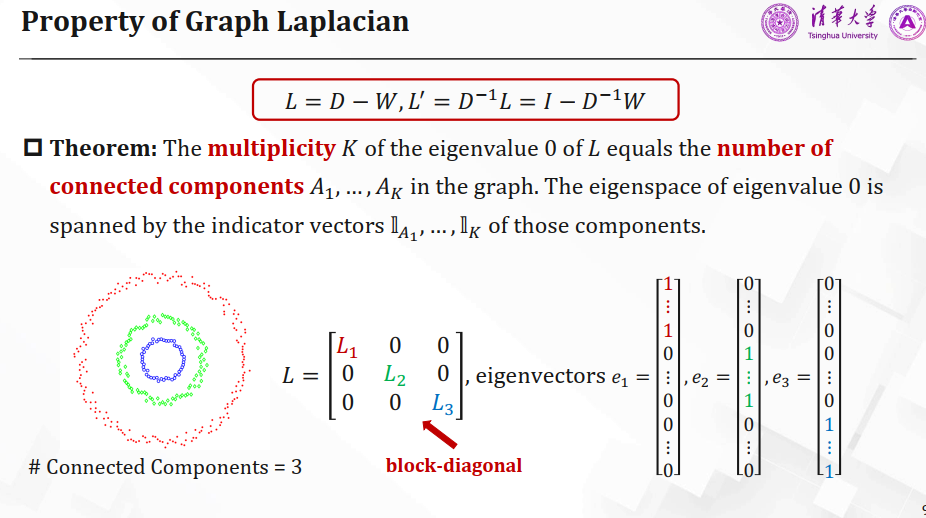
上面的推导想要说明什么
说明只要是有connected在一起的,就会有这个特征向量,可以看有多少个这样的block和去判断到底有几层连接欸。
最小割问题
最小割(MinCut)问题是图论中的经典问题之一,目标是将一个图划分为两个部分,使得连接这两个部分的边的权重之和最小。具体来说,最小割问题的目的是找到一组边,这组边的删除可以将图分成两个不相交的子图,同时这组边的总权重最小。
正式定义:
给定一个无向图 ,其中:
- 是顶点集合,表示图中的节点。
- 是边集合,表示节点之间的连接。
每条边 具有一个权重 ,表示节点 和节点 之间的连接强度。
最小割问题的目标是将图 划分为两个不相交的子集 和 (即 且 ),使得从 到 的所有边的权重之和最小。
数学上,最小割的定义为:
其中, 是连接 中顶点 和 中顶点 之间边的权重。
图示解释
考虑一个简单的无向图:
- 图中有若干个顶点和连接这些顶点的边。
- 每条边都有一个权重,表示连接这两个顶点的强度或成本。
在最小割问题中,我们希望找到一个最优的划分 和 ,使得这两个集合之间的边的权重和最小。
最小割的意义
-
网络分割:在网络安全和通信网络中,最小割问题可以用来寻找网络的薄弱点或瓶颈,通过找到网络中最易断开的部分,增强网络的鲁棒性。
-
图像分割:在图像处理领域,最小割用于图像分割,通过找到像素间最小的割,使得图像被分成具有不同特征的区域。
-
电路设计:在VLSI设计中,最小割用于优化电路布局,减少芯片面积和电路延迟。
计算复杂度
最小割问题可以通过多项式时间算法解决。例如,Stoer-Wagner算法可以在 时间复杂度内找到图的最小割。
实际例子
假设我们有以下无向图:
(A) / | \1 2 3/ | \(B)-(C)-(D)边的权重分别为:
- 边 的权重为1
- 边 的权重为2
- 边 的权重为3
- 边 的权重为1
- 边 的权重为1
为了找到最小割,我们需要将图划分为两个子集,使得从一个子集到另一个子集的边的权重和最小。
一种可能的划分是:
在这种划分下,割的权重为1 + 2 + 3 = 6,这是因为从 到 有三条边,权重分别为1、2和3。
另一种可能的划分是:
在这种划分下,割的权重为1,这是因为从 到 只有一条边 ,权重为1。
显然,第二种划分方式是最小割,割的权重最小。
但是简单选择最小的边做分割可能会导致问题:
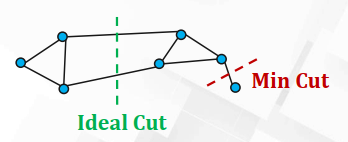
将一个孤立点分割出来,我们希望分割之后的集合比较均衡。
归一化割(Normalized Cut)
定义:将图划分为两个集合 和 ,使得连接集合 中顶点和集合 中顶点的边的权重之和最小,并且集合 和 的大小是可比较的。
公式:
- :集合 的体积,即集合 中所有顶点的度数之和。
- :集合 的体积,即集合 中所有顶点的度数之和。
对于 个集合的划分,归一化割定义为:
归一化割的目标是鼓励平衡的划分,避免孤立顶点的问题。
归一化割和图拉普拉斯矩阵(Graph Laplacian)
假设:
命题:
其中 是图的拉普拉斯矩阵, 是度矩阵。
证明: 利用拉普拉斯矩阵的性质,证明归一化割公式。
最小化归一化割(Minimize Normalized Cut)
问题:考虑归一化割,设簇为 和 :
-
离散优化:这个问题是 NP-困难的。
-
连续放松:通过求解广义特征值系统将优化问题放松到连续域:
这个问题被称为 Rayleigh 商,等价于:
拉格朗日函数: 对第一个约束定义拉格朗日函数并求偏导数:
所以 是 的特征值,对应的特征向量是 。
目标: 最小化目标:
最小特征值 ,对应特征向量 ,违反约束 。
解决方案: 第二小的特征值 是问题的真实解:
如果 ,则 ,第二个约束得到满足。
谱聚类算法(Spectral Clustering Algorithm)
谱聚类是一种基于图论的聚类算法,通过图的谱(特征值和特征向量)来进行数据的聚类。与传统的基于距离的聚类方法(如k-means)不同,谱聚类可以处理非凸形状的数据,并且在许多情况下具有更好的性能。
主要思想
谱聚类将数据表示为图的形式,其中节点表示数据点,边的权重表示数据点之间的相似度。然后通过图的拉普拉斯矩阵计算图的特征值和特征向量,将数据映射到低维空间中进行聚类。
步骤
谱聚类通常包括以下步骤:
- 构建相似度矩阵(Similarity Matrix)
- 计算图拉普拉斯矩阵(Graph Laplacian)
- 计算拉普拉斯矩阵的特征向量
- 进行聚类
详细步骤
- 构建相似度矩阵
相似度矩阵 是一个 的矩阵,表示数据点之间的相似度。常见的相似度度量包括:
- 高斯相似度(Gaussian Similarity):对于数据点 和 ,定义相似度为:
- k近邻(k-nearest neighbors):仅考虑每个点的前k个最近邻居。
- 计算图拉普拉斯矩阵
根据相似度矩阵 ,计算度矩阵 和拉普拉斯矩阵 :
- 度矩阵 是一个对角矩阵,其中 表示节点 的度数:
- 拉普拉斯矩阵 定义为:
也可以使用归一化拉普拉斯矩阵:
- 对称归一化拉普拉斯矩阵:
- 非对称归一化拉普拉斯矩阵:
- 计算拉普拉斯矩阵的特征向量
计算拉普拉斯矩阵 或归一化拉普拉斯矩阵的前 小的特征值对应的特征向量,形成特征向量矩阵 。
特征向量矩阵 的每一行对应于一个数据点,将这些行作为新的表示,将数据点映射到低维空间中。
- 进行聚类
对特征向量矩阵 的每一行进行聚类,常用的方法是k-means聚类。聚类的结果就是数据点的最终分类。
实例
假设我们有一组数据点 ,我们想将这些点分成两类。具体步骤如下:
- 构建相似度矩阵 :
- 计算度矩阵 :
- 计算拉普拉斯矩阵 :
- 计算特征向量矩阵 :求解 的前两个最小特征值对应的特征向量,假设特征向量为:
- 聚类:对 的每一行进行 k-means 聚类,得到最终的分类结果。
总结
谱聚类算法通过图的拉普拉斯矩阵的特征值和特征向量,将数据点映射到低维空间中,然后进行聚类。这种方法在处理非凸形状的数据时表现良好,并且可以揭示数据的内在结构。
八、Feature Selection & Dimension Reduction
分类
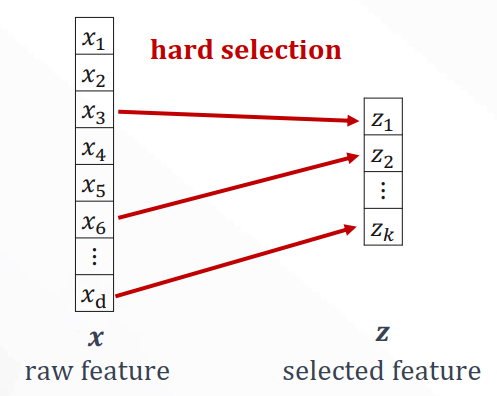
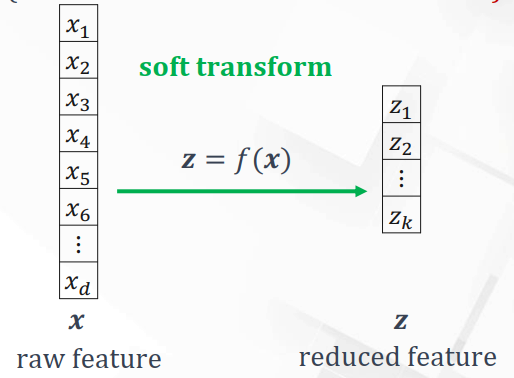
| Hard Extraction | Soft Extraction |
|---|---|
| Select 𝒌 features from 𝒅 features. | Transform a 𝒅-dim feature to 𝒌-dim. |
 |  |
Feature Selection
Feature Selection: Filtering
优点:
- 非常快速(无需训练)
- 实施简单
缺点:
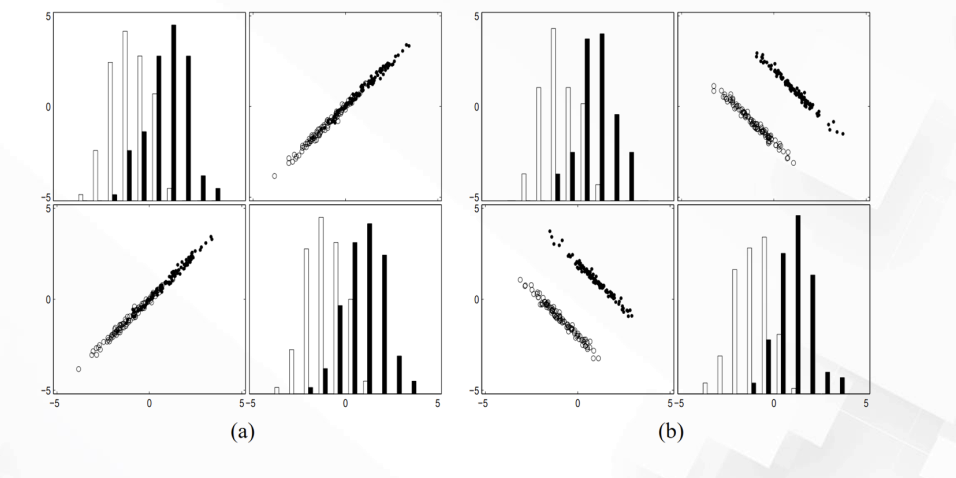
- 没有考虑特征之间的相互作用:看似 “无用 “的特征与其他特征组合后可能有用
但是完全相关的变量实际上不会增加任何的信息:图片中的图表(a)和(b)展示了两个变量的关系。在图(a)中,变量之间是正相关的,而在图(b)中,变量之间是负相关的。无论是正相关还是负相关,如果两个变量之间的相关性是完美的(相关系数为1或-1),加入第二个变量对模型的信息量贡献是零。
Embedding:LASSO Regression
基本思想:
-
在某些情况下,我们可以将特征选择嵌入到归纳算法中。也就是说,在模型训练的过程中,同时进行特征选择。
-
线性回归模型通过最小化误差的平方和(Sum of Squared Errors, SSE)来拟合数据点。公式表示为:。其中, 是模型的权重向量, 是特征向量, 是观测值。
-
为了控制模型的复杂度,我们引入了模型复杂度惩罚项(如 损失),并将其嵌入到训练损失中。更新后的损失函数表示为:。其中, 是一个正则化参数,控制复杂度惩罚的强度, 表示 的 范数(即所有权重绝对值的和)。
-
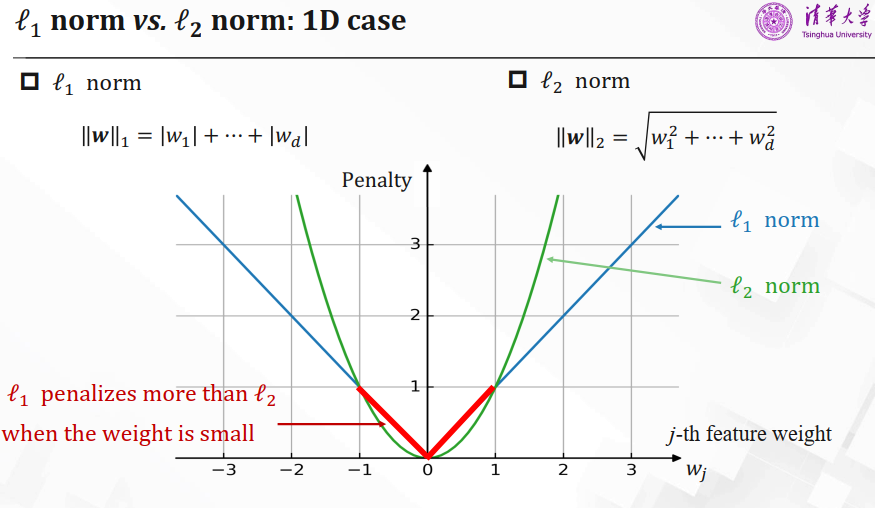
表示将第 个特征从模型中移除。由于 损失的特性,它倾向于生成稀疏的权重向量(即很多权重为零),从而自动实现特征选择。
问题
- 为什么 损失会产生稀疏解?是稀疏的意味着完成了feature selection
Dimension Reduction
主成分分析(PCA)是一种线性降维技术,用于将高维数据投影到低维空间中,同时尽量保留数据的主要变异信息。PCA通过找到数据的主成分(即方差最大的方向)来实现这一目标。
1、数据中心化
首先,对数据进行中心化处理,使得每个特征的均值为零。假设原始数据矩阵为 ,其中 为 的矩阵,表示 个样本,每个样本有 个特征。
中心化后的数据矩阵 为: 其中, 是特征均值向量,维度为 。
2、计算协方差矩阵
接下来,计算中心化数据的协方差矩阵 :
3、特征值分解
对协方差矩阵 进行特征值分解,得到特征值和特征向量。设 的特征值为 对应的特征向量为 。特征值按从大到小排序。
4、选择主成分
选择最大的 个特征值对应的特征向量,作为数据降维后的新坐标轴。这些特征向量组成了一个 的变换矩阵
5、数据变换
将原始数据 变换到新的低维空间,得到降维后的数据矩阵 :
| 示意图 | 的作用 |
|---|---|
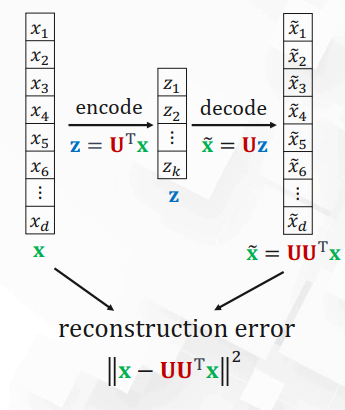 | 矩阵 的两个功能: 编码:,其中 。 解码:。 |
1. PCA目标1:最大化投影方差
投影到正交方向
我们希望将数据投影到一组正交方向上,以最大化每个方向上的投影方差。这些方向用矩阵 表示,满足 。
最大化每个方向上的投影方差
对于给定的方向 ,投影后的方差为 。
学习目标
其中 。
假设数据已被中心化,即 : 约束条件:。
2. PCA目标2:最小化重构误差
矩阵 的两个功能:
- 编码:,其中 。
- 解码:。
我们希望重构误差 尽可能小,因此学习目标为:
3. 两个目标的等价性
数据方差 = 捕获的方差 + 重构误差
取期望
最小化重构误差等价于最大化捕获的方差。
4. 找到一个主成分
最大化投影数据的方差: 约束条件:。
推导
使用拉格朗日乘子法求解: 对 求导并设为零:
因此,最大化 等价于最大化 ,即 是 的最大特征值。
5. 找到第二个主成分
第二个主成分与第一个主成分正交:
目标
最大化第二维投影数据的方差: 约束条件:,且 。
拉格朗日函数
对 求导并设为零:
因为, 并且,所以,所以
因此
因此,最大化 等价于最大化 ,即 是 的第二大特征值。
6. 计算PCA:特征值分解
最大化投影数据的方差: 约束条件:,且 对 。
第 主成分是 的第 大特征值对应的特征向量。
特征值分解
其中 是 的特征向量。
总结:PCA通过最大化投影方差和最小化重构误差这两个等价目标来找到一组正交的主成分。每个主成分对应于数据协方差矩阵的一个特征向量,按照特征值的大小排序。通过特征值分解,可以有效地计算PCA。
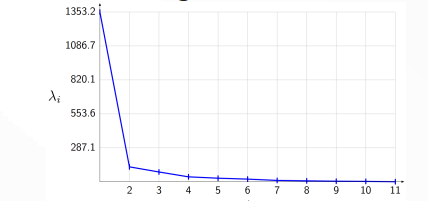
How many principal components?
看下图,也就是说在特征值急剧下降之后,就不把那些特征值考虑进去了。
很关键的一句话:
Magnitude of eigenvalues indicate fraction of variance captured.
为什么这么说呢?
在PCA(主成分分析)中,我们的目标是将高维数据投影到一个较低维的空间中,同时尽可能保留数据的主要信息。PCA通过寻找数据协方差矩阵的特征值和特征向量来实现这一目标。
以下是详细的解释步骤:
-
协方差矩阵:我们首先计算数据的协方差矩阵,它表示了数据中每对变量之间的线性关系。协方差矩阵的对角线元素表示每个变量的方差,非对角线元素表示变量之间的协方差。
-
特征值和特征向量:我们对协方差矩阵进行特征值分解,得到一组特征值和对应的特征向量。特征向量表示新坐标系的方向,而特征值表示沿这些方向的数据分布的广度。
-
方差解释:特征值的大小表示了数据在对应特征向量方向上的分散程度。特征值越大,说明数据在该方向上的方差越大,即数据在这个方向上的变化越显著。
-
主成分:PCA选择具有最大特征值的特征向量作为主成分。主成分是数据投影后的新基向量,每个主成分的特征值表示了该主成分所解释的原始数据的方差比例。总方差是所有特征值的和,单个特征值除以总特征值之和就表示了该特征值所解释的方差比例。
-
捕获的方差比例:因此,特征值越大,表示该特征向量(即主成分)捕获的数据方差比例越高。PCA通过选择前几个最大的特征值对应的特征向量,尽可能多地保留原始数据的方差,从而实现降维。
将PCA和LDA进行对比
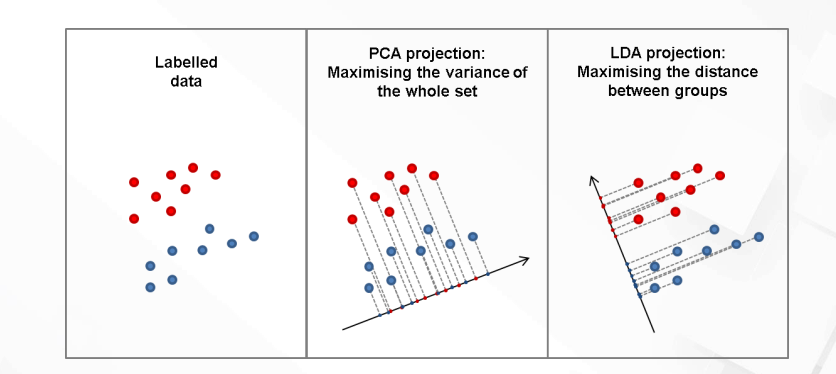
数据特征的多样性:PCA的目标是通过寻找数据方差最大的方向,将高维数据投影到这些方向上,从而减少维度并保留尽可能多的原始信息。PCA所关注的是数据特征的多样性和变化,而不考虑标签。
忽略标签信息:由于PCA不考虑标签信息,因此它无法直接用于分类任务中的特征选择或降维。PCA只能在无监督学习和数据预处理的背景下应用,例如降维、数据可视化和噪声过滤等。
在有标签的情况下,我们可以使用LDA进行降维,减轻数据的复杂程度,还可以提高分类性能
- 目标
-
PCA(Principal Component Analysis):
- 目标:最大化数据的方差,找到数据中方差最大的方向,将数据投影到这些方向上。
- 应用场景:无监督学习,数据压缩,降维,噪声过滤和数据可视化。
-
LDA(Linear Discriminant Analysis):
- 目标:最大化类间差异,最小化类内差异,找到能够最有效区分不同类别的数据投影方向。
- 应用场景:有监督学习,分类任务中的特征提取和降维。
- 数据预处理步骤
PCA
- 标准化数据:对数据进行标准化处理,使每个特征具有相同的尺度。
- 计算协方差矩阵:计算数据的协方差矩阵。
- 特征值分解:对协方差矩阵进行特征值分解,得到特征值和特征向量。
- 选择主成分:选择前k个最大特征值对应的特征向量,形成新的基向量。
- 数据投影:将数据投影到这些基向量上,得到降维后的数据。
LDA
-
标准化数据:对数据进行标准化处理,使每个特征具有相同的尺度。
-
计算类内散布矩阵:计算每个类别的均值向量和类内散布矩阵。
-
计算类间散布矩阵:计算总体均值向量和类间散布矩阵。
-
特征值分解:计算类内散布矩阵的逆乘以类间散布矩阵,进行特征值分解,得到特征值和特征向量。
-
选择判别成分:选择前k个最大特征值对应的特征向量,形成新的基向量。
-
数据投影:将数据投影到这些基向量上,得到降维后的数据。
-
预处理效果比较
PCA
- 无监督:PCA不使用数据的标签信息,只考虑数据特征的空间分布情况。
- 最大化方差:PCA通过最大化方差来选择重要特征,保留数据的主要变化。
- 降维效果:适用于降维、数据压缩和去噪,但不能提高分类性能。
LDA
- 有监督:LDA使用数据的标签信息,通过最大化类间差异和最小化类内差异来选择重要特征。
- 分类性能:LDA可以提高分类性能,因为它在降维过程中考虑了类别信息。
- 降维效果:适用于分类任务中的特征提取和降维,有助于提高分类器的性能。
- 优缺点
PCA
- 优点:
- 简单易用,适用于无监督学习任务。
- 通过最大化方差,可以有效减少数据维度和噪声。
- 缺点:
- 不考虑标签信息,在分类任务中效果可能不如LDA。
- 对线性关系敏感,不能捕捉非线性特征。
LDA
- 优点:
- 考虑类别信息,可以提高分类任务的性能。
- 在处理有标签数据时,效果优于PCA。
- 缺点:
- 需要类别标签信息,适用于有监督学习。
- 适用于线性可分的数据,对于非线性数据效果有限。
Multi-Dimensional Scaling (MDS)
pairwise distances
流程步骤:
- 输入和输出:
- 输入:n个对象在d维空间中的欧几里德距离。
- 输出:点的位置(不考虑旋转、反射和平移)。
- 一般思想:
- 距离矩阵 :包含所有点对之间的欧几里德距离。
- 观察到可以用点的内积矩阵 来表示距离。
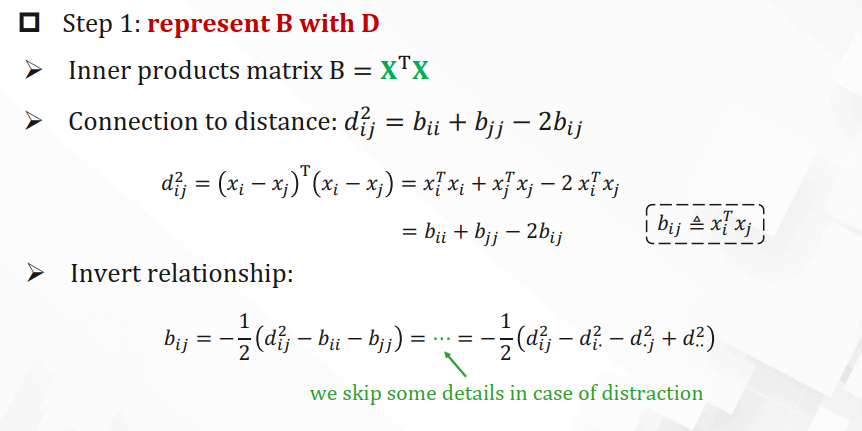
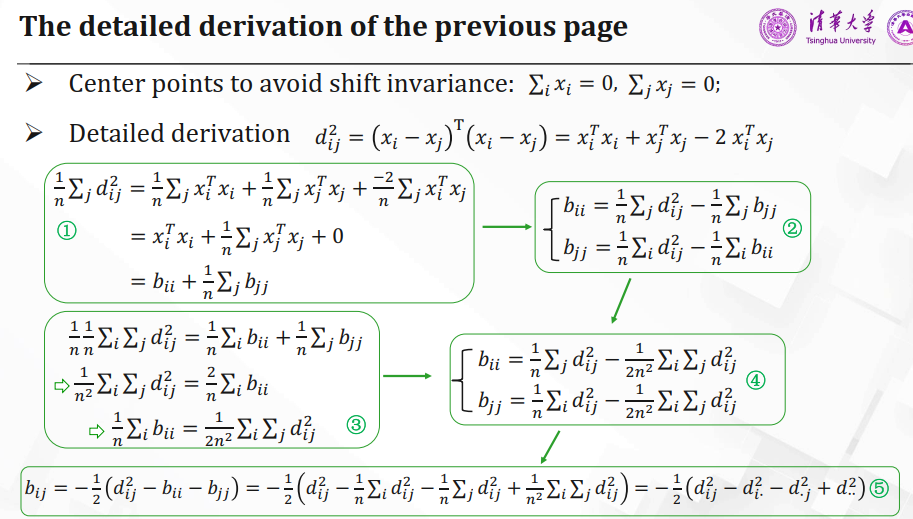
- 步骤1:用距离矩阵表示内积矩阵 :
- 内积矩阵 。
- 利用距离的关系 ,可以推导出 的表达式。
- 通过一些数学推导,最终得到 。
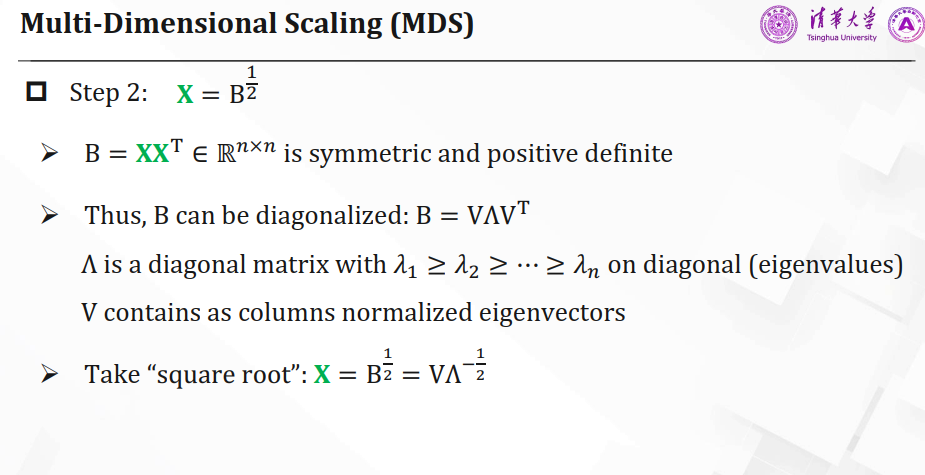
- 步骤2:对 进行特征值分解:
- 是对称正定的,可以进行特征值分解:,其中 是对角矩阵,对角线元素是特征值。
- 取“平方根”: 。
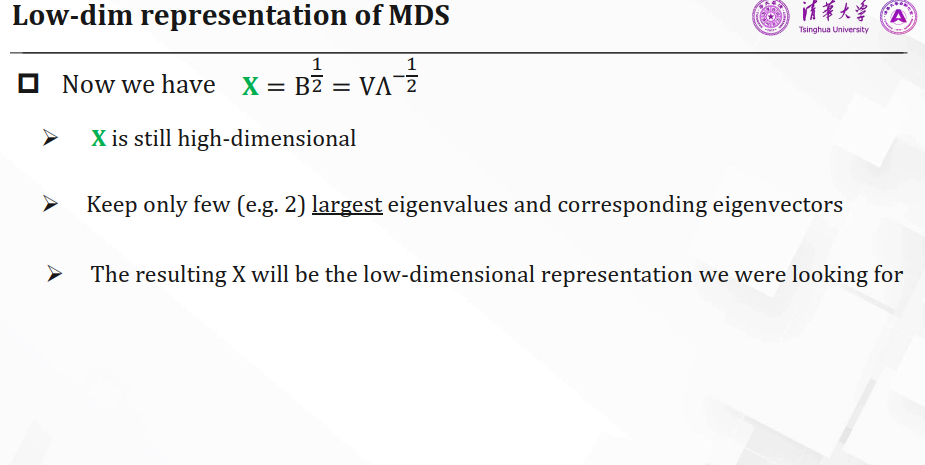
- 低维表示:
- 虽然 仍是高维的,但可以选择保留前几个最大的特征值和对应的特征向量。
- 最终得到低维表示的 。
数学推导过程
 |  |
|---|---|
 |  |
低维分解的详细解释
-
特征值分解:
- 在MDS中,内积矩阵 通过特征值分解 得到,其中 是特征向量矩阵, 是对角矩阵,对角线上是特征值。
- 这个过程类似于PCA中对协方差矩阵进行特征值分解的步骤。
-
保留主要特征:
- 在MDS中,特征值表示了内积矩阵在对应特征向量方向上的重要性。
- 保留前几个最大的特征值和对应的特征向量,就相当于PCA中选择主要的主成分。
-
低维表示:
- 通过保留最大的特征值和对应的特征向量,构建新的低维表示矩阵 ,这类似于PCA中通过保留主要主成分来降维。
- 虽然 起初是高维的,但只保留前几个主成分(特征向量)之后, 就变成了低维表示。
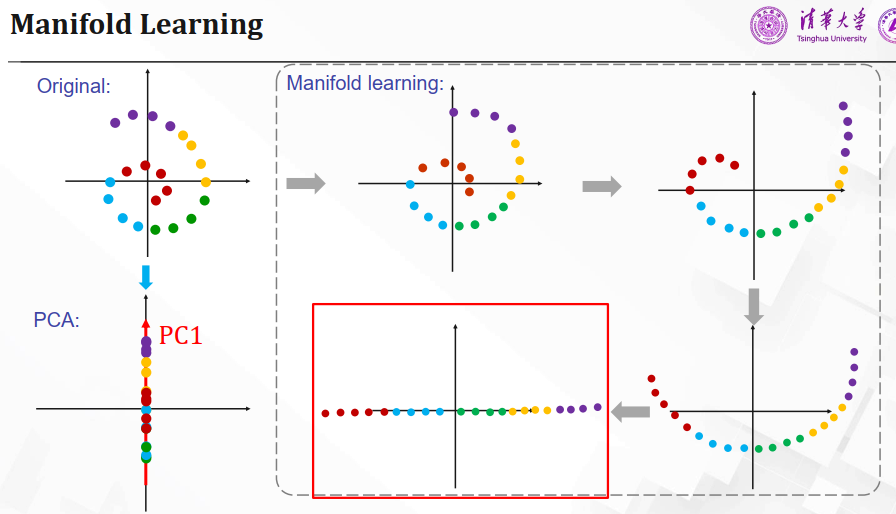
Manifold learning
对比图:
九、Neural Networks (Classical)
Neural networks are simplified models of the brain composed of large numbers of units (the analogs of neurons) together with weights that measure the strength of connections between the units
引入
单层感知机不能做XOR问题,对于线性不可分的问题存在局限性,所以引入MLP。
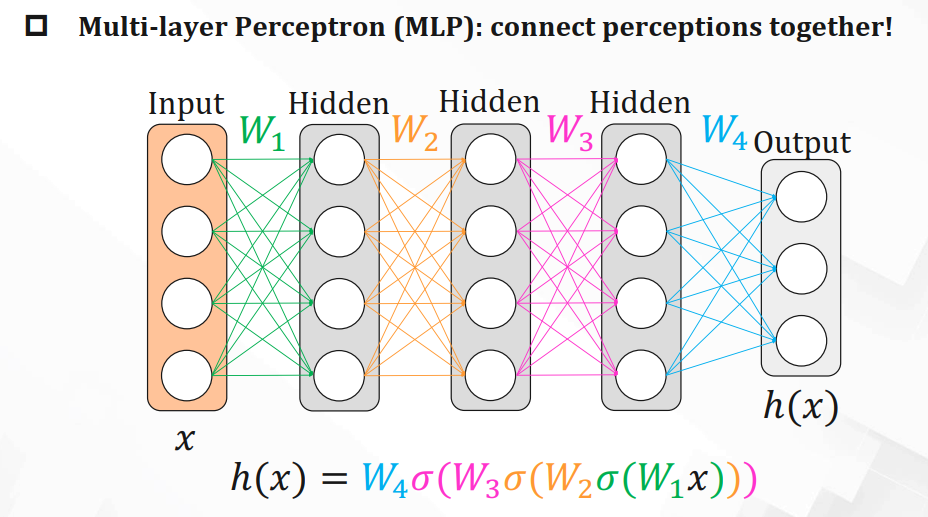
优点:
- **Multi-level representations :**每一层表征某一个特征
前向传播过程:
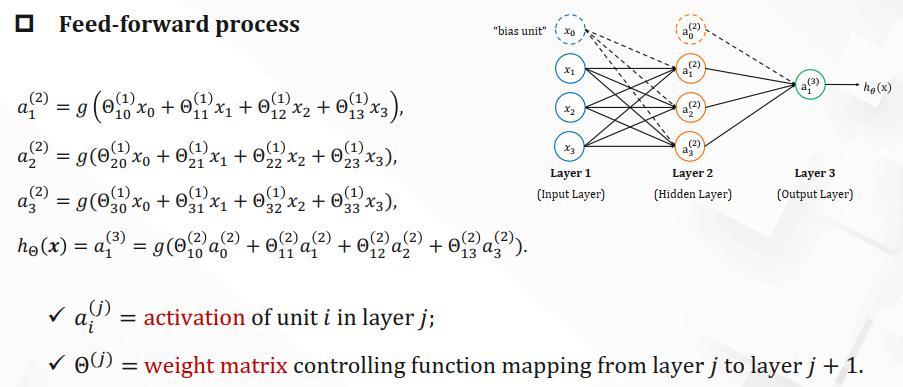
在神经网络中,每一层的权重矩阵的维度是由前一层和后一层的单元(神经元)数量决定的。
公式
权重矩阵之间的关系:
如果网络在第 层有 个单元,在第 层有 个单元,那么对应的权重矩阵 的维度为:
其中, 中的 是因为包含了偏置项。
向量化:
-
计算第 2 层的输入
- 这里, 是从输入层到第 2 层的权重矩阵, 是输入向量。
- 计算得到第 2 层每个单元的加权和 。
-
计算第 2 层的激活
- 这里, 是激活函数(如 sigmoid, tanh, ReLU 等)。
- 将加权和 输入到激活函数 中,得到第 2 层的激活值 。
-
添加偏置项
- 为了在下一层计算中包含偏置项,在 向量前添加一个值为 1 的偏置项。
-
计算第 3 层的输入
- 这里, 是从第 2 层到第 3 层的权重矩阵, 是第 2 层的激活向量(包括偏置项)。
- 计算得到第 3 层每个单元的加权和 。
-
计算第 3 层的激活
- 这里, 是激活函数。
- 将加权和 输入到激活函数 中,得到第 3 层的激活值 ,即最终的输出 。
Loss Function的设置
- 在回归问题当中:和
- 在分类问题当中:cross-entropy
详细讨论cross-entropy
交叉熵损失函数是分类问题中常用的损失函数,它用于最小化神经网络预测分布与真实标签分布之间的差异。
定义与公式
-
定义: 交叉熵损失函数的目标是最小化神经网络的预测分布与真实标签分布之间的差异。
-
多分类问题:
- 神经网络输出每个类别的预测概率,这些概率和为1。
- 真实标签向量是one-hot编码的,即在真实类别位置上为1,其余位置为0。
-
公式: 交叉熵损失函数 定义为:
其中:
- 是真实标签的概率(对于one-hot编码的真实标签,只有一个 为1,其余为0)。
- 是神经网络对第 类的预测概率。
详细解释
-
神经网络的预测分布:
- 对于多分类问题,神经网络输出一个概率向量 ,表示每个类别的预测概率。
- 这些预测概率的总和为1,即 。
-
真实标签分布:
- 真实标签向量 是one-hot编码的。例如,对于三个类别(猫、狗、马)的分类问题,如果真实类别是狗,真实标签向量可能是 。
-
交叉熵损失函数公式:
- 交叉熵损失函数衡量真实标签分布与预测分布之间的差异。
- 在one-hot编码情况下,真实类别位置上的 ,其他位置上的 ,所以交叉熵损失函数只考虑真实类别的位置。
Backpropagation
注意:需要随机初始化
1. 对称性破坏
如果所有的权重都初始化为相同的值,那么在第一次前向传播和反向传播中,所有的神经元将执行完全相同的计算,导致更新后的权重仍然相同。这种情况被称为对称性破坏(Symmetry Breaking)。
具体来说:
- 在前向传播过程中,所有神经元会计算出相同的激活值。
- 在反向传播过程中,计算得到的梯度也是相同的。
由于更新规则是一样的,所有权重的更新量也将相同。因此,尽管权重在每次迭代中都会更新,但它们始终保持相同的值。
2. 具体例子
假设我们有一个简单的网络,其中每一层的权重都初始化为相同的值(例如0)。在这种情况下:
-
前向传播:
-
对于第 层的权重矩阵 和偏置向量 ,假设初始值均为0。
-
输入 经过第 层时,激活值 计算如下:
-
-
由于激活值 为0,所有后续的层也将计算得到相同的激活值。
-
反向传播:
- 在反向传播过程中,梯度也会因为相同的初始权重而相同,导致权重更新量一致。
3. 无法学习
由于每一层的神经元在每次迭代中的更新都是相同的,这意味着网络的每个神经元都在做相同的事情。没有个体差异,网络无法学习到不同特征,最终无法有效地训练模型。
4. 解决方法:随机初始化
为了打破对称性,通常使用随机初始化来设置初始权重。随机初始化确保了每个神经元有不同的初始权重,从而在前向传播和反向传播中执行不同的计算。这使得网络能够学习到数据的不同特征。
常用的随机初始化方法有:
- 高斯初始化:从正态分布中抽取随机值。
- 均匀初始化:从均匀分布中抽取随机值。
- Xavier初始化(Glorot初始化):考虑到前一层和后一层的节点数量,确保权重的方差适中。
- He初始化:专为ReLU激活函数设计,权重的方差略大于Xavier初始化。
梯度反传的计算
公式和步骤
假设我们有一个简单的四层神经网络,如图所示:
- 输入层:
- 隐藏层1:使用激活函数
- 隐藏层2:使用激活函数
- 输出层:使用激活函数
我们需要计算每层的梯度,并通过梯度下降算法更新权重。
前向传播
- 隐藏层1计算:
- 隐藏层2计算:
- 输出层计算:
损失函数
假设损失函数为二分类交叉熵损失函数:
反向传播
- 输出层误差:
- 隐藏层2误差:
其中, 表示元素乘积(Hadamard积)。
- 隐藏层1误差:
- 梯度计算: 根据 计算每层权重的梯度:
总结
- 输出层梯度:
- 隐藏层2梯度:
- 隐藏层1梯度:
-
权重更新:
- 输入层到隐藏层1:
- 隐藏层1到隐藏层2:
- 隐藏层2到输出层:
Gradient Check
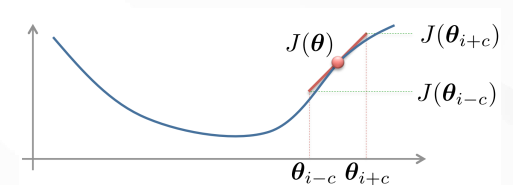
也就是说,只将某一个参数上下稍微改变一些,通过数值的方法计算梯度
一些神经网络的变式
1. 径向基函数网络(Radial Basis Function Network)
径向基函数网络是一种高效的学习系统,其特点是使用单一隐藏层,并采用径向基函数作为激活函数。其输出是输入向量的标量函数,计算公式为:
- :隐藏层的神经元数量
- :第 个神经元的中心向量
- :线性输出神经元的权重
- :通常采用高斯函数
径向基函数网络的输出是输入向量到每个中心向量的距离的函数,加权后得到输出。这种网络在支持向量机(SVM)中也有应用,帮助将数据转换到高维空间。其实和核函数方法用核函数隐式升维有点像。
2. 赫布法则(Hebb’s Rule)
赫布法则是神经学习的一个原则,强调了同时激活的神经元之间的连接强度会增加。这被总结为“共同激发的神经元之间的连接会增强”。赫布法则的权重更新公式为:
- :学习率
- :分别为神经元 和 的激活值
如果两个神经元都具有高激活值,那么它们之间的权重更新会很大;反之,若其中一个激活值低,则权重更新较小。
3. 霍普菲尔德网络(Hopfield Network)
霍普菲尔德网络是一种递归神经网络,用于联想记忆和模式识别。它具有对称的权重连接,能够存储和检索基于联想记忆的模式。其权重满足:
- :对称权重连接
- :自连接权重为零
霍普菲尔德网络可以应用赫布法则进行权重更新。
4. 随机网络与随机厨房水槽(Random Network & Random Kitchen Sinks)
随机网络和随机厨房水槽方法用于快速非线性特征变换:
- 随机网络:神经网络具有固定的、随机初始化的权重,将输入数据转换到高维特征空间,无需训练。
- 随机厨房水槽:通过使用随机特征投影来近似复杂的核函数,使得对大数据集进行高效的非线性变换成为可能。
主要思想:
- 无需训练:权重是固定的,训练过程只涉及到线性部分。
- 非线性特征变换:通过随机投影实现复杂的非线性变换。
十、Optimization and CNN
This is a link to a different site and this is a link to a section inside this page.
Here’s a table:
| Number | Next number | Previous number |
|---|---|---|
| Five | Six | Four |
| Ten | Eleven | Nine |
| Seven | Eight | Six |
| Two | Three | One |
You can use MathJax to write LaTeX expressions. For example: When \(a \ne 0\), there are two solutions to \(ax^2 + bx + c = 0\) and they are
How about a yummy crepe?
It can also be centered!
{: .mx-auto.d-block :}
Here’s a code chunk:
var foo = function(x) { return(x + 5);}foo(3)And here is the same code with syntax highlighting:
var foo = function(x) { return(x + 5);}foo(3)And here is the same code yet again but with line numbers:
{% highlight javascript linenos %} var foo = function(x) { return(x + 5); } foo(3) {% endhighlight %}
Boxes
You can add notification, warning and error boxes like this:
Notification
Note: This is a notification box.
Warning
Warning: This is a warning box.
Error
Error: This is an error box.
Local URLs in project sites {#local-urls}
When hosting a project site on GitHub Pages (for example, https://USERNAME.github.io/MyProject), URLs that begin with / and refer to local files may not work correctly due to how the root URL (/) is interpreted by GitHub Pages. You can read more about it in the FAQ. To demonstrate the issue, the following local image will be broken if your site is a project site:
If the above image is broken, then you’ll need to follow the instructions in the FAQ. Here is proof that it can be fixed:
