

阅读日期 ·
论文 AnyCalib: On-Manifold Learning for Model-Agnostic Single-View Camera Calibration,Javier Tirado-Garín、Javier Civera,ICCV 2025。
页内目录 任务概览 · 研究背景 · 方法原理 · 网络架构 · 实验结论 · 优点与局限 · 来源
任务概览
- 输入 一张自然场景图像,可以是透视图、经裁剪或非均匀拉伸的图像,也可以带有镜头畸变。
- 中间表示 网络对整幅图像做密集预测,生成覆盖 个像素的 FoV 场。每个像素 的两个 FoV 分量可以转换为相机坐标系中的单位射线方向。
- 输出 用像素坐标和射线的对应关系拟合选定的相机模型,得到焦距、主点和相应的畸变参数。求解阶段无需为所选模型单独训练一个预测头。
本文的任务范围是相机内参标定。位姿估计则需要求相机相对于世界或参考坐标系的旋转和平移。
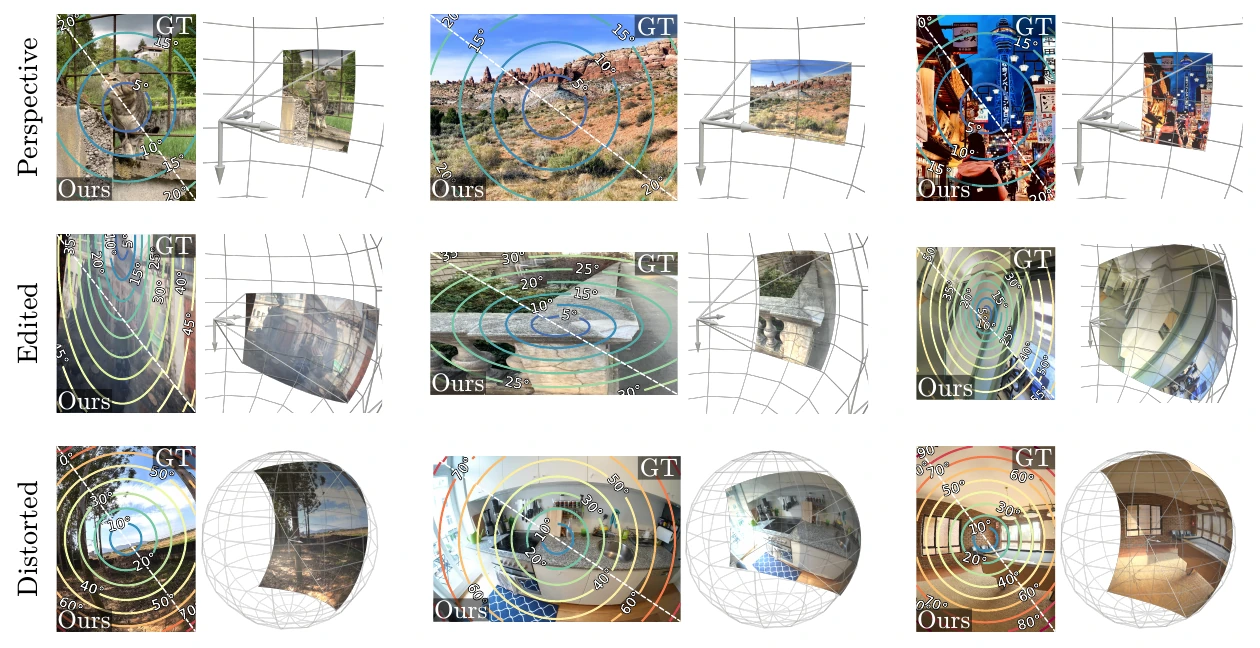
图 1 透视、经编辑和畸变图像上的标定示例。来自论文图 1。
研究背景
单张自然图像缺少标定板或多视角对应提供的约束。依赖消失点、平行线或地平线的几何方法需要场景中有足够清晰的线索。直接回归内参的学习方法往往绑定某类投影模型。遇到裁剪、非均匀拉伸或强畸变时,固定的主点、焦距比例和畸变假设都会影响标定。
AnyCalib 把问题拆成两个阶段。先从图像学习像素对应的射线,再根据这些射线求解所选模型的内参。
方法原理
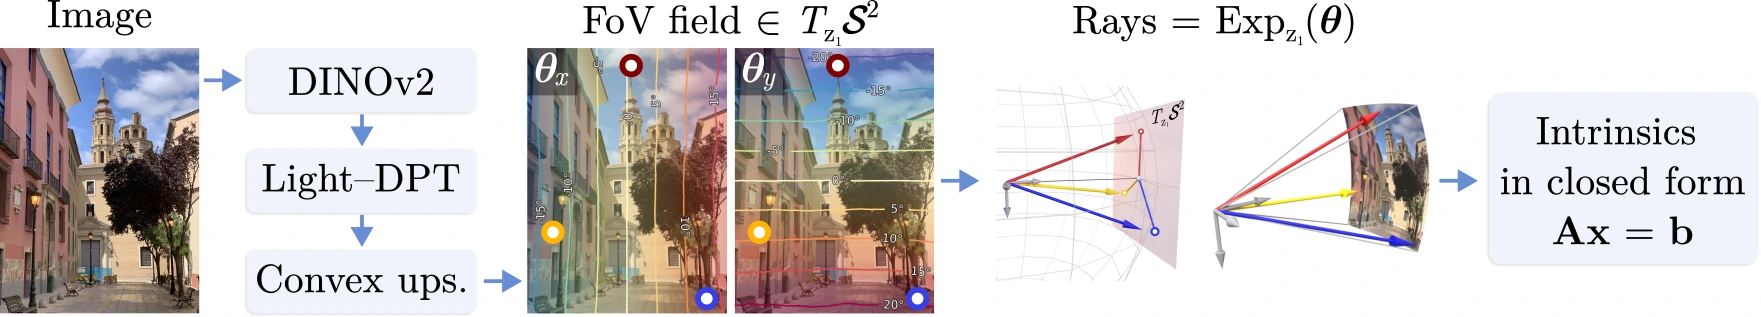
图 2 从单张图像到 FoV 场、单位射线和内参的求解流程。来自论文图 2。
视场场与单位射线
FoV 场定义在单位球面 上以相机光轴为切点的切平面。网络给每个像素预测二维坐标 ,其模长表示射线与光轴的夹角。通过球面指数映射,可将这两个分量转换为单位射线方向。这样,不同相机模型可以共用同一种中间表示。
闭式恢复内参
选定相机模型后,把像素坐标与预测射线代入该模型的投影关系。对于论文覆盖的一类模型,可重排方程,通过线性最小二乘或带约束的求解得到内参初值。论文给出的例子包括针孔、Brown–Conrady 和 Kannala–Brandt 模型。
高斯–牛顿细化
以闭式结果为起点,执行五次高斯–牛顿迭代,最小化预测射线与当前相机参数生成的射线之间的角度残差。闭式解的全局最优性对应前一步的代数目标。后续非线性角度优化的结果取决于初始化和预测射线的质量。
网络架构
- 特征提取 用 DINOv2 预训练的 ViT-L 处理输入图像。
- 轻量解码 用基于 DPT 的 CNN 解码器在低分辨率上预测二维 FoV 分量,省去转置卷积。
- 密集输出 通过凸上采样恢复到输入分辨率,再将 FoV 分量映射成逐像素单位射线。
- 几何求解 由射线与像素的对应关系恢复内参,并执行角度残差细化。
实验结论
论文分别在透视图、编辑图和畸变图上评估。指标包括水平和垂直视场角误差、重投影误差与反投影射线角误差。在所报告的基准上,AnyCalib 相比已有单图标定方法表现更好,在透视图实验中也达到与部分大型 3D 基础模型相当或更好的结果。论文的单个训练数据集包含 5.4 万张合成图像,用于对比的部分 3D 基础模型使用了超过 300 万张训练图像。
优点与局限
优点
- 模型可在推理时选择 同一射线预测可用于多种受支持的相机模型。
- 覆盖编辑图像 针对裁剪和拉伸训练的版本可估计偏移的主点及不同方向的焦距。
- 推理开销低 论文报告在 RTX 4090 上完成一次标定约需 25 ms。
局限
- 单图线索有限 场景纹理单一、缺乏深度层次时,图像对射线的约束较弱,预测更容易出现不确定性。
- 对初始化有依赖 强畸变下,细化效果取决于闭式初值、射线预测和相机模型与真实投影的匹配程度。