

图像切成 Patch 后,为什么还要加入位置编码和分类 Token?这份互动精读从 ViT 的输入讲到 Q/K/V 和多头注意力,再回到原论文图表,比较训练数据规模和计算量怎样影响分类表现。
论文原文(ICLR 2021) · 调整 Patch 尺寸 · 动手计算注意力权重
章节目录与进度管理
学习进度保存在当前浏览器,下次打开可以继续。
阅读方法:先理解,再推导,最后用实验验证
每章按照看原文 → 跟着推导 → 动手实验 → 完成测验 → 不看答案复述的顺序进行。每道题选中后立即给出反馈,页首的学习进度随作答实时更新。
掌握标准:本章 3 题全部答对,并勾选“我能够不看答案复述”。这是自测状态,不能等同于由教师验证的知识掌握。复习时可修改答案,状态会重新计算。
为什么要把 Transformer 用于图像?
对应原论文:Abstract;§1 Introduction;§2 Related Work · PDF 第 1–2 页
作者想回答的不是“注意力能不能用于图像”,而是:如果把图片切成 Token,尽可能直接使用标准 Transformer,是否仍能获得有竞争力的图像分类表现?
CNN 的优势 卷积天然假设局部邻域重要,并具有权重共享和平移等变性;这些视觉先验帮助模型在数据较少时学习。
ViT 的想法 只在输入端做 Patch 切分,利用标准 Transformer Encoder 建立各区域的关系;其图像专用归纳偏置更少。
为什么这是一个科学问题?
如果小数据集上 CNN 更好,而扩大预训练数据集后 ViT 反超,就说明模型结构中的归纳偏置与可用于学习的数据规模之间存在重要关系。
先记住限制:原论文的核心实验在监督分类预训练与图像分类迁移环境下进行;不要直接外推到所有视觉任务。
原文:Dosovitskiy et al., ICLR 2021,§1,PDF pp.1–2。
从图像到 Token:看懂 Figure 1 和公式 (1)
对应原论文:§3.1,Figure 1,公式 (1) · PDF 第 3–4 页
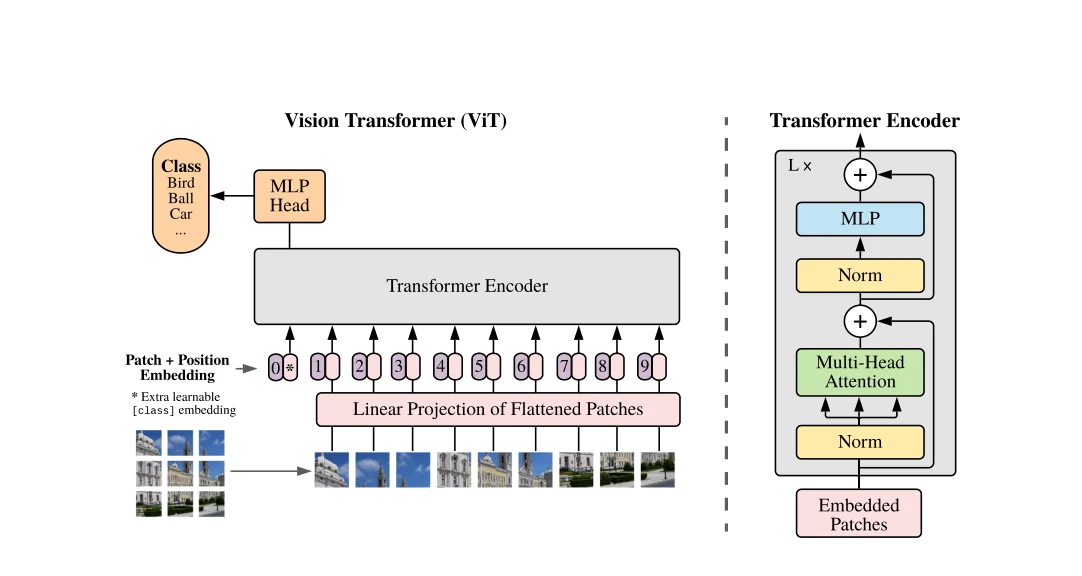
假设输入为 RGB 图像 224 × 224 × 3,Patch 为 16 × 16。一共得到:
每个 Patch 有 16 × 16 × 3 = 768 个像素通道数值。展平并乘以可学习矩阵 E 后,变成一个 D 维向量。注意:即使输入维度与输出维度同为 768,线性投影仍是一个可学习的变换。
Class Token 在 196 个 Patch Token 前加一个可学习的分类 Token,得到 197 个 Token。最后读取它的输出表示。
Position Embedding 给每个 Token 加入可学习的位置向量;否则标准自注意力本身不能从排列中直接得知图像的二维位置信息。
互动实验 A · 调整 Patch 尺寸
固定输入分辨率为 224 × 224。改变 Patch 边长,观察 Token 数量和注意力矩阵规模。
一句话记忆:Patch Embedding 把二维图片变成序列,Position Embedding 补充位置信息,Class Token 负责提供最终的图像分类表示。
原文:§3.1,Figure 1,公式 (1);Table 1(ViT-B/16 隐藏维度 768)。
先弄清:Self-Attention 与 MLP 的区别
对应原论文:§3.1 Inductive Bias;公式 (2)–(3) · PDF 第 4 页
想象 3 个 Patch Token 分别来自图像中的猫耳朵、猫身体和猫尾巴,记为 z₁、z₂、z₃。问题是:更新 z₁ 时,能不能直接用到 z₂ 的信息?
MLP:逐个 Token 加工 z₁ → f(z₁)
z₂ → f(z₂)
z₃ → f(z₃) 同一个 MLP 的参数作用于每个 Token,但每一行的计算不直接读取其他行。
Self-Attention:跨 Token 聚合 z₁、z₂、z₃ → 新的 z₁
z₁、z₂、z₃ → 新的 z₂
z₁、z₂、z₃ → 新的 z₃ 每个 Query 可以对所有 Key 计算权重,再对所有 Value 做加权聚合。
举例:一个 Token 的注意力输出可以写成 o₁ = 0.2v₁ + 0.5v₂ + 0.3v₃。这里的系数为教学举例,实际系数由模型计算。
关键细节:MLP 不会在它自身的这一层运算中直接混合其他 Token,但它输入的特征可能已经被前一个 Self-Attention 层融合过。因此“MLP 没有跨 Token 信息”也是不准确的说法。
原文:§3.1(“Inductive bias” 段落),PDF 第 4 页。
从 Q、K、V 到 Multi-Head Attention
对应原论文:Appendix A,公式 (5)–(8) · PDF 第 13 页
第 1 步:从同一个 X 投影出三种向量
对 ViT-B/16,一张图像的单层输入是 X ∈ ℝ197×768。在一个注意力头中,Q、K、V 使用不同的可学习参数投影:
12 个头、隐藏维度 768,所以每个头的维度通常为 dh = 768/12 = 64。三个投影后的形状均为 197 × 64。
第 2 步:Q 与 K 计算两两匹配分数
得到的矩阵有 197 行和 197 列。第 i 行第 j 列表示:第 i 个 Query 对第 j 个 Key 的匹配分数。
第 3 步:缩放和 Softmax
每一行做 Softmax,得到非负且总和为 1 的注意力权重。除以 √dh 是为了缓解高维点积过大带来的 Softmax 饱和问题。
第 4 步:真正实现信息混合的是 A · V
其中第 i 行输出是所有 Value 向量的加权和:oᵢ = Σⱼ Aᵢⱼ vⱼ。这就是跨 Token 信息交换的数学本质。
互动实验 B · 亲手调注意力权重
假设某个 Query 对 3 个 Key 的匹配分数可调,Value 向量固定为 v₁=(1,0)、v₂=(0,1)、v₃=(1,1)。改变分数,查看 Softmax 与 AV 输出如何变化。
第 5 步:多个头并行,拼接,再投影
每个注意力头输出 197 × 64;沿特征维拼接 12 个头之后变成 197 × 768,再经过输出线性投影,得到与原输入同样的形状。
一条主线:Q/K 决定“向谁取信息”,Softmax 得到“取多少”,V 提供“取什么”,AV 才完成信息聚合。
原文:Appendix A,公式 (5)–(8),PDF 第 13 页。演示数字为教学构造。
把注意力放回 Transformer Encoder
对应原论文:§3.1,公式 (2)–(4),Table 1 · PDF 第 4–5 页
原论文采用Pre-LN(先归一化,再进入子模块);每个 Encoder Block 由一个 MSA 子模块和一个 MLP 子模块组成,两处都加入残差连接。
公式 (2):跨 Token 信息交互
先做 LN,再做 MSA,把 MSA 的输出加回原输入。残差连接帮助保留原信息并改善深层网络训练。
公式 (3):逐 Token 特征变换
ViT-Base 的 MLP 通常是 768 → 3072 → 768,中间使用 GELU;对每个 Token 独立应用相同的参数。
输出为什么仍是 197 × 768?
因为 MSA 的输出投影回 D=768,MLP 的第二层也投影回 D=768。这样才能与残差分支逐元素相加。
ViT-B/16 重复这个 Encoder Block 12 层。最终取第 0 个位置的 Class Token:
得到整张图像的表示 y。微调时,论文使用一个线性分类头把 y 映射到下游任务的类别数 K。注意:y 本身是特征表示,而不是概率。
| 模型 | 层数 | 隐藏维度 D | MLP 隐藏维 | 注意力头数 |
|---|---|---|---|---|
| ViT-Base | 12 | 768 | 3072 | 12 |
| ViT-Large | 24 | 1024 | 4096 | 16 |
| ViT-Huge | 32 | 1280 | 5120 | 16 |
原文:§3.1,公式 (2)–(4);Table 1(模型配置),PDF 第 4–5 页。
读懂实验:ViT 在什么条件下更好?
对应原论文:§4.2–4.4,Figure 3–5,Table 2、5、6 · PDF 第 6–7、15 页
Figure 3:同一架构,换不同规模的预训练数据集
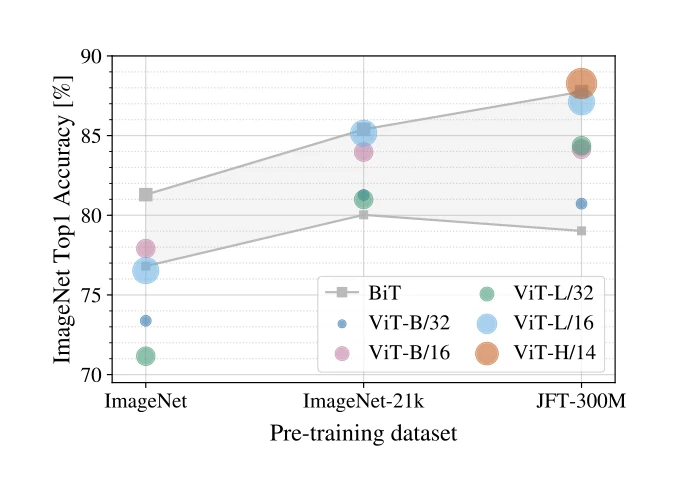
| 预训练数据 | ViT-B/16 | ViT-L/16 | 更高者 |
|---|---|---|---|
| ImageNet | 77.91% | 76.53% | Base |
| ImageNet-21k | 83.97% | 85.15% | Large |
| JFT-300M | 84.15% | 87.12% | Large |
观察:在较小的 ImageNet 上,Large 比 Base 更差;预训练数据扩大后,Large 逐步超过 Base。这支持了数据规模影响 ViT 的模型容量收益这一结论。
Figure 4:控制数据来源,改变样本数量
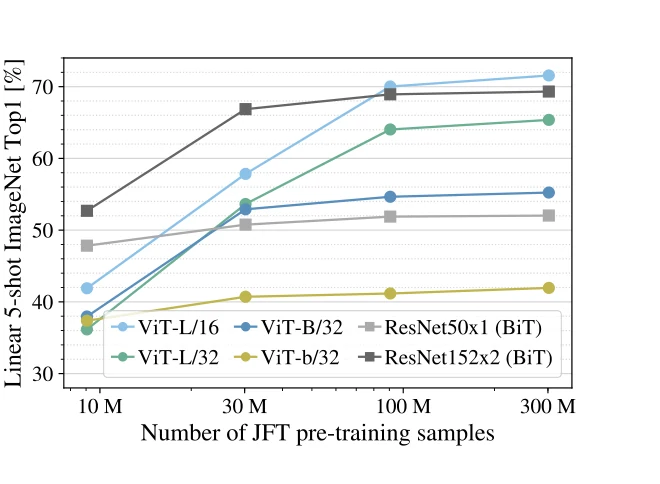
为什么 Figure 4 比 Figure 3 更进一步? 因为 Figure 3 还更换了数据来源,Figure 4 在同一来源内改变样本规模,减少了数据分布差异造成的混淆。但这仍不是严格孤立“归纳偏置”的因果实验。
Figure 5:比较相似性能所需要的预训练计算量
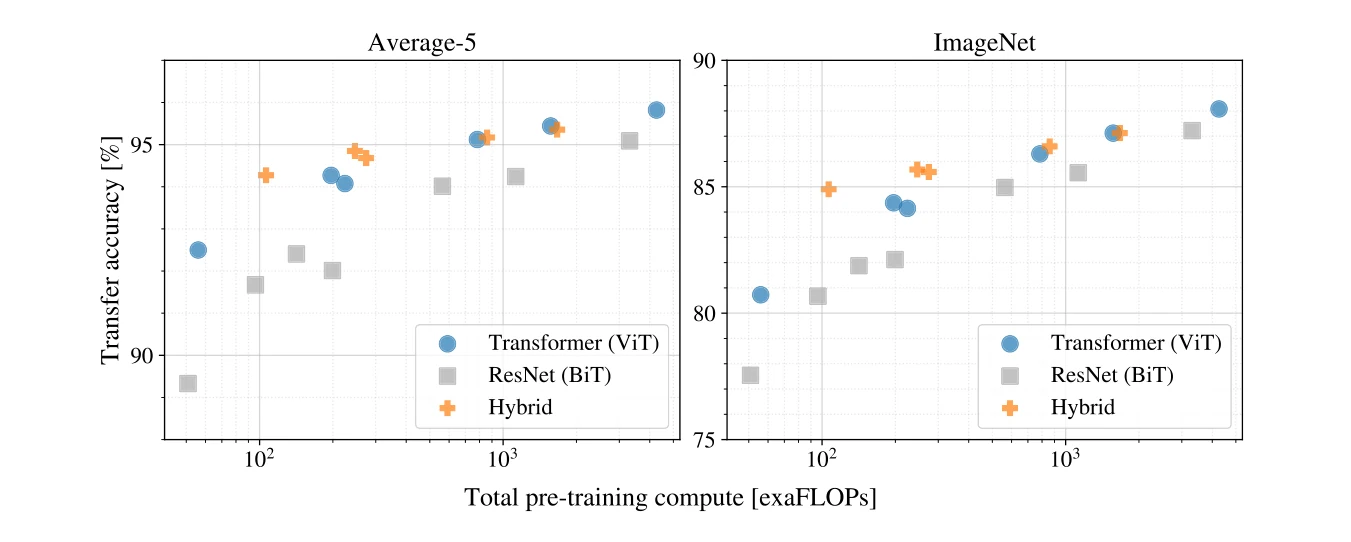
这张图要学会两种读法:同一准确率,越靠左越省计算;同一计算量,越靠上准确率越高。
| 指标(JFT 训练 7 epochs) | ViT-B/16 | ResNet152x2 |
|---|---|---|
| ImageNet 准确率 | 84.15% | 84.97% |
| 五个迁移分类任务平均准确率(计算值) | ≈94.08% | ≈94.01% |
| 预训练计算量 | 224 exaFLOPs | 563 exaFLOPs |
在这组具体比较中,ViT-B/16 的计算量约是 ResNet152x2 的 40%,而五个任务的平均准确率接近。论文控制实验的整体观察为:ViT 达到相近性能所用的预训练计算量约为 ResNet 的 1/2 至 1/4。
Table 2:最强配置是否真的有竞争力?
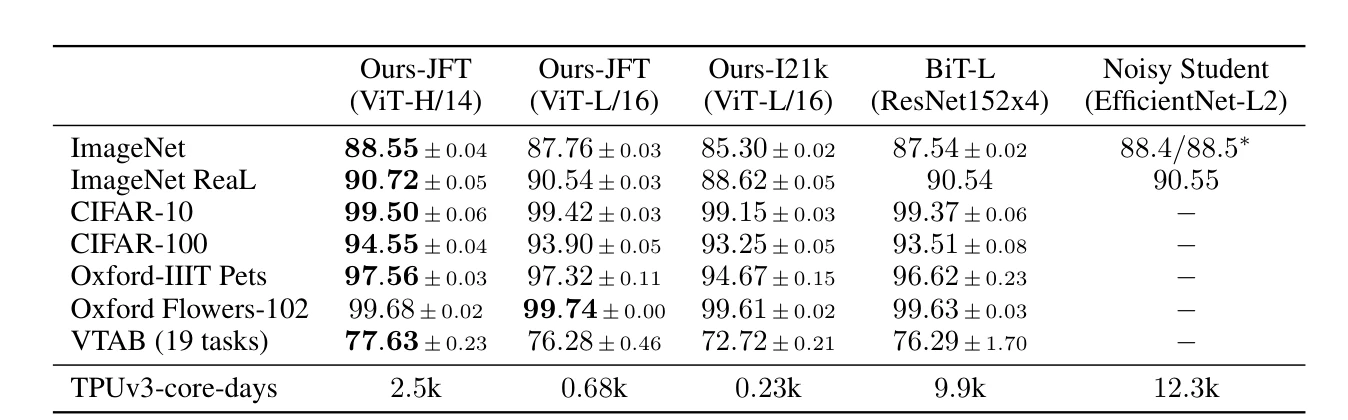
科研阅读警戒线:“预训练 FLOPs 更少”不等于“所有硬件上推理更快”。Figure 5 的成本指标、Table 2 的 TPUv3-core-days、模型推理延迟是不同概念。也不要把 Table 2 的 88.55% 与其他微调设置下的数字直接混用。
原文:§4.2–4.4、Appendix C Table 5–6。五项平均值由 Table 6 的 ImageNet、CIFAR-10/100、Pets、Flowers 结果计算。
Figure 7:ViT 学到了什么?还能推论什么?
对应原论文:§4.5–5,Figure 7;Appendix D.7 · PDF 第 8–9、20 页
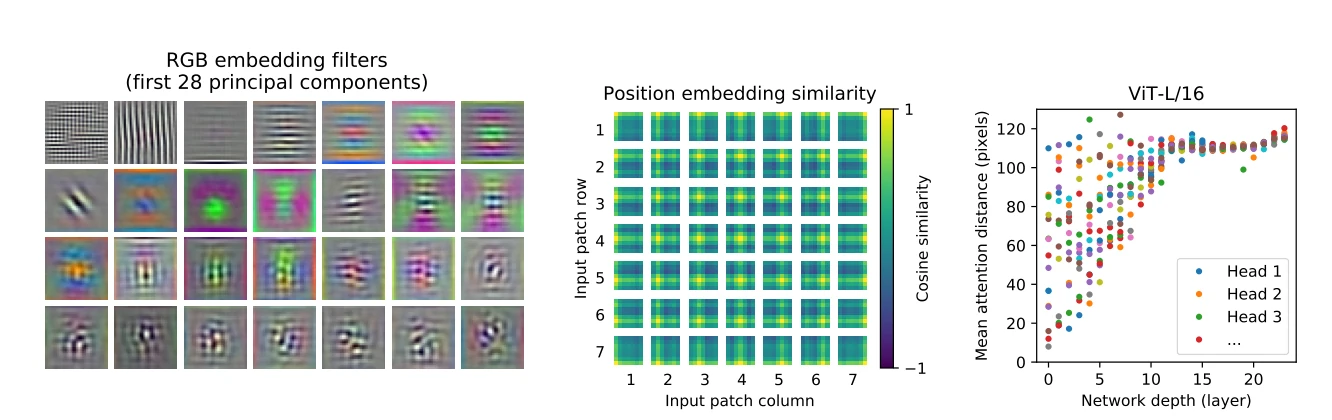
左图:Patch Embedding 学到局部视觉结构
线性投影滤波器的主成分看起来类似边缘、条纹、颜色等局部视觉基函数。说明 ViT 即使不把标准卷积写进主干,也能够从数据中学到某些局部视觉模式。
中图:一维可学习位置编码能学到二维拓扑
作者比较了不同 Patch 位置向量之间的余弦相似度:邻近位置及同一行列的位置往往有相关结构。它说明位置编码捕捉到一定的二维空间关系,不意味着已经理解三维几何。
右图:不同层、不同头的注意力距离不同
浅层既有偏局部的头,也有远距离交互的头;随网络深度增加,注意力距离整体增大。注意力距离描述的是权重聚合的空间跨度,不能单独证明某个注意力头“因果上决定了分类结果”。
论文已经证明 Patch 序列可用于图像分类;大规模预训练条件下 ViT 具有高性能和有竞争力的预训练效率;内部表征呈现一定空间结构。
论文尚未解决 检测、分割等其他视觉任务的通用适配;高效自监督预训练;仅用此论文并不能直接得到深度图、相机位姿或三维重建结果。
科研阅读结束时应记住:方法有效 ≠ 所有条件都有效;注意力可视化提供线索 ≠ 因果证明。
原文:§4.5、§4.6、§5;Figure 7;Appendix D.7。
读完之后:用自己的话讲一遍整篇论文
完整复述应包含一条科研逻辑:研究问题 → Patch Token 化 → QKV 与多头注意力 → Encoder 与分类 → 数据规模实验 → 计算成本实验 → 模型表示与局限。
- 问题:标准 Transformer 不依赖 CNN 主干,能否完成高质量图像分类?
- 方法:图像切成 Patch,再做线性投影、加入 Class Token 和位置编码、通过 Encoder 交互特征。
- 机制:Q 与 K 计算权重,AV 完成跨 Token 信息聚合,MLP 逐 Token 变换特征。
- 证据:Figure 3–4 研究数据规模,Figure 5 研究计算量,Figure 7 分析学到的特征。
- 边界:这些实验主要是分类和迁移场景,不能直接推出所有视觉任务或所有设备上的最优性。
引用和进一步阅读
Dosovitskiy, A., et al. An Image Is Worth 16x16 Words: Transformers for Image Recognition at Scale. ICLR 2021. arXiv:2010.11929v2.
图表为作者原论文节选,已标注原始页码和图号。教学数值示例及文字讲解不等同于原文实验。学习状态只依据本页选择题与自主复述勾选,不构成严格的学习能力测评。