

窗口注意力把计算限制在局部。可如果相邻的两个 Token 恰好分在不同窗口,它们怎样交换信息?这份手册沿着一张 224×224 图像走过 Swin-T 的四个 Stage,再用一张可以点击的 8×8 网格,看清移动窗口、循环移位和 Attention Mask 各自做了什么。
回顾 ViT 精读 · 原论文 PDF · 试试移动窗口 · 查看 PyTorch 示例
手册目录 · 18 章
00|这份手册该怎么读?
目标不是背诵网络结构,而是能沿着一张图像的数据流解释:为什么做、做了什么、张量怎么变化、有什么证据证明有效。
一条主线 ViT 的局限 → 分层特征和局部窗口 → 移动窗口跨区通信 → Mask 保证正确性 → 位置偏置与效率 → 实验验证。
边界说明:标注“论文事实”的内容来自原论文 PDF;演示、算例与伪代码是为了教学补充的推导,不是论文原图或原始源码。模型效果仅对应论文当时的实验条件,不能当作目前的最新性能排名。
建议阅读顺序
- 先读 01–05 巩固为什么需要 Swin,完整理解形状变化和 Block 的两个残差子层。
- 把 06–09 连起来读 从局部 Attention 到移动窗口,再到 Cyclic Shift / Mask / Relative Position Bias,这是技术核心。
- 再读 10–13 掌握效率推导、模型变体、消融实验以及代码级的数据排列。
- 最后做 15 的自测 无需全对,但应该能自己讲清“为什么 Mask 是必需的”。
01|为什么在 ViT 之后还需要 Swin?
论文定位:第 1–2 页,Abstract、Introduction、Figure 1。
原始 ViT(Vision Transformer) 将图像切成 Patch,再让所有 Patch 在 Transformer 中参与全局 Self-Attention。这对图像分类很有效,但作为通用视觉主干(backbone)时,有两个特别突出的设计挑战。
挑战 A · 尺度不同 图像中的物体可大可小,目标检测和语义分割往往需要不同空间尺度的特征图。原始 ViT 主干在各层通常保持相同 Token 网格尺度。
挑战 B · 高分辨率 全局 Attention 的每个 Token 都要和其他 N 个 Token 求关联。仅注意力矩阵的规模就随 N² 增长,密集预测会变昂贵。
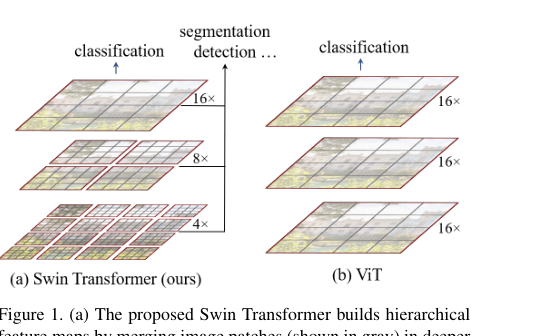
| 维度 | 原始 ViT | Swin Transformer |
|---|---|---|
| 基本输入 | Patch Token | Patch Token |
| 主干空间尺度 | 大体单一尺度 | 四阶段层次化特征 |
| Attention 范围 | 全局 | 固定大小局部窗口 |
| 跨窗口信息 | 直接全局访问 | 靠相邻的 W-MSA / SW-MSA 逐层传播 |
| 定位 | 首先为图像分类建立强基线 | 通用视觉 Backbone,兼顾分类和密集预测 |
一句话总结:Swin 的两根主线是 Hierarchical(分层) 以及 Shifted Window(移动窗口):前者帮助多尺度表达,后者在局部计算的效率与跨窗口交流之间取得平衡。
不要误解:“ViT 不适合直接作为多尺度 Backbone”不等于“ViT 不能做检测或分割”。ViT 可以借助额外结构适配密集任务,论文比较的是架构的适配方式和效率。
02|真正需要的 ViT 基础:补到刚好够用
读过 ViT 后,你只需要确认以下概念,才能顺利理解 Swin 的实现。
| 概念 | 直觉 | 在 Swin 中是否保留? |
|---|---|---|
| Token / Patch | 用向量表示图像的局部区域 | 保留;起始 Patch 通常为 4×4 |
| Q / K / V | 查询、匹配、聚合内容 | 保留;限制在一个窗口内 |
| Multi-Head | 并行学习多组相关性 | 保留;各 Head 维度通常 32 |
| LayerNorm | 对每个 Token 的通道特征归一化 | 保留,Pre-LN |
| Residual | 输出 = 输入 + 学到的更新 | 保留,每个 Block 两处 |
| MLP | 每个 Token 内部非线性变换 | 保留,默认 C → 4C → C |
这里 QKT 是匹配分数,Softmax 把每行变成权重,乘 V 代表按照权重聚合信息。MLP 不直接混合不同 Token,它对每个 Token 的通道特征做变换;跨 Token 交换主要由 Attention 完成。
形状口诀:LN 不变形;Attention 不变形;MLP 临时扩维再还原;Residual 要求相加的张量形状一致。真正降低空间分辨率的是 Patch Merging。
03|整个 Swin-T:沿数据流看四个 Stage
论文定位:第 3–4 页 §3.1、Figure 3;第 10 页 Table 7。以下以 224×224 输入、Swin-T 为例。
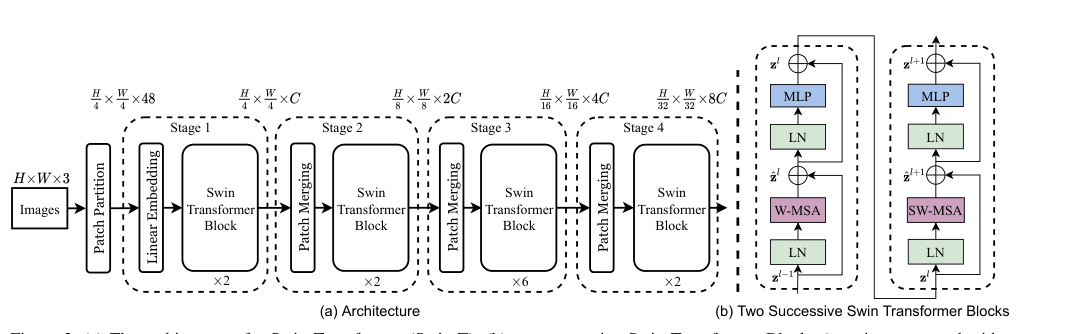
224×224×3 → 4×4 Patch → Linear Embedding → Stage 1–4
输入如何变成 Token?
Patch Partition:4×4×3 = 48 个原始数值构成一个 Token;224/4 = 56,因此共有 56×56 = 3136 个 Token。接着 Linear Embedding 把每个 48 维 Token 投影成 C=96 维。
四个 Stage 的形状
| Stage | 特征图(H × W × C) | Token 数 | Block 数 |
|---|---|---|---|
| STAGE 1 | 56×56×96 | 3136 | 2 |
| STAGE 2 | 28×28×192 | 784 | 2 |
| STAGE 3 | 14×14×384 | 196 | 6 |
| STAGE 4 | 7×7×768 | 49 | 2 |
关键规律:每次 Patch Merging → 高宽各减半,Token 总数变为 1/4,通道数变为 2 倍。Stage 内多个 Block 通常不改变当前的 H×W×C。
一个经常出现的误解
Stage 的“输出分辨率降低”说的是特征图空间网格变小,不代表原始图像又被物理缩小处理了一遍。更深层单个 Token 对应更大范围的原图内容,但这不意味着每个 Token 都能直接关注整张图。
分类头怎么接?
论文附录 A2.1 说明:用于图像分类时,Stage 4 的特征图经过 Global Average Pooling(全局平均池化),再接线性分类器;论文认为这与使用 ViT 式 class token 的分类精度相当。来源:论文第 9 页 A2.1。
04|Patch Merging:不是平均池化
输入形状为 H×W×C,把每组相邻的 2×2 个 Token 拼接成 4C 维,再经过线性投影变成 2C 维。
拼接 Concatenate 例如原本 4 个 Token 都是 96 维:
[A(96), B(96), C(96), D(96)] → 1 个 384 维向量。不是求均值、不是把四个向量逐元素相加。
线性投影 Projection 将每个 384 维拼接向量映射为 192 维。最终每 4 个旧 Token 对应 1 个新 Token;空间高宽减半。
容易混淆:MLP 也会执行 96→384→96,但它不减少 Token 数量。Patch Merging 是 4 个位置合并成 1 个位置,它承担下采样职责。
从第二阶段开始,得到越来越粗粒度的特征,可以更方便地交给 FPN、UPerNet 等依赖多尺度特征的任务结构。来源:论文 §3.1,第 3–4 页。
05|Swin Transformer Block:内部到底做了什么?
可以把它看成 ViT Encoder Block,只把原先全局 MSA 换成局部 W-MSA 或 SW-MSA。别的基础构件——LayerNorm、MLP、Residual——仍然存在。
Block 1 · W-MSA LN → 普通窗口注意力 → 残差相加 → LN → MLP → 残差相加。
Block 2 · SW-MSA LN → 移动窗口注意力 → 残差相加 → LN → MLP → 残差相加。
Pre-LN:先 LayerNorm,再送入子模块。Residual:分别绕过 Attention 和 MLP 各自的计算分支,将旧表示加回来。
论文公式 (3) 通过 ẑl 和 zl 区分“Attention 子层后的中间输出”和“整个 Block 后的输出”;连续两个 Block 就是这两组公式依次执行。
这些模块分别改变什么?
| 模块 | 负责什么 | 改变 H×W×C? |
|---|---|---|
| LayerNorm | 归一化每个 Token 的 C 个通道 | 不改变 |
| W-MSA | 固定窗口内部 Token 交互 | 不改变 |
| SW-MSA | 移动后的窗口内部交互 | 不改变 |
| MLP | 逐 Token 非线性变换,C→4C→C | 最终不改变 |
| Residual | 输入与变换输出逐元素相加 | 不改变 |
| Patch Merging | 下采样并合并相邻 Token | 改变 |
为什么 LayerNorm?稳定特征尺度与训练。为什么 MLP?通过升维、GELU、降维,提高逐 Token 特征变换的表达能力。为什么 Residual?保留直接传递输入与梯度的路径,有助于深层优化。
一分钟复述:一个 Block 内先由 Attention 处理 Token 之间的关系,再由 MLP 处理各 Token 的特征;两次都用 Pre-LN 与残差相加。两个相邻 Block 只有窗口划分方式不同。
06|W-MSA:从 56×56 到 49×49 的注意力矩阵
论文第 4 页 §3.2:Self-attention in non-overlapped windows;默认 M=7,Swin-T Stage 1 的 C=96、Heads=3。
假设特征图大小是 56×56×96。将其按 7×7 的窗口划分:窗口数 = (56/7)² = 64;每个窗口有 49 个 Token。
56×56×96 → 64×49×96 → 64×3×49×32 → Attention
每个 Head 的维度为 96/3 = 32。对每个窗口、每个 Head,Q/K/V 都有 49×32 的形状,因此 QKᵀ 产生 49×49 的相关性矩阵。
窗口间使用同一套可学习投影参数,但注意力权重由每个窗口自身的特征决定。最后合并 Heads、做输出投影并还原空间排列,输出形状再次回到 56×56×96。
| 注意力分数(每个 Head) | 元素数 | 计算 |
|---|---|---|
| 全局 Attention 分数数量 / Head | 9,834,496 | 3136 × 3136 |
| W-MSA 分数数量 / Head | 153,664 | 64 × 49 × 49 |
这里是注意力分数元素数量减少 64 倍的例子,不代表整个网络快 64 倍。线性投影、MLP、显存访问和硬件实现仍有额外开销;严格复杂度推导在第 10 章。
07|Shifted Window:不是让整张图做全局 Attention
论文第 2 页 Figure 2、第 4 页 §3.2:连续 Block 先固定窗口 W-MSA,再改用 SW-MSA。
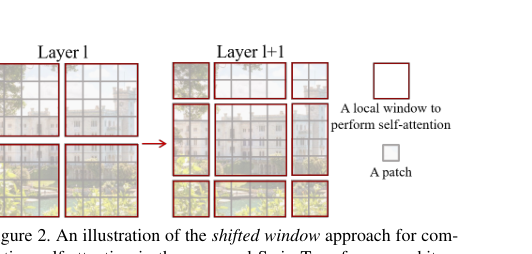
只用固定窗口,窗口 A 内的 Token 只能从 A 内部取信息;旁边的窗口 B 无法直接交换信息。Swin 的做法是在下一层把窗口边界移动约半个窗口,令一个新窗口覆盖原来多个窗口的部分 Token。
W-MSA 先在固定窗口内部交流。计算可控,但不同窗口在本层之间互不访问。
SW-MSA 下一个 Block 改变分组;新窗口跨过旧边界,使先前不同组的部分 Token 得以通信。
关键限定:W-MSA + SW-MSA 不会让每个 Token 在两层后就“访问到全图所有 Token”。跨区域信息是在堆叠 Block 的过程中逐层传播的。
默认窗口边长 M = 7,偏移通常为 floor(M/2) = 3 个 Token。Figure 2 为了说明原理,用的是 8×8 Token、4×4 窗口、移动 2 格的示意场景。
08|Cyclic Shift + Attention Mask:怎样屏蔽循环移位产生的虚假连接?
论文第 5 页 §3.2,Figure 4。下面的一维算例及 8×8 交互网格是教学补充,帮助还原论文机制。
先区分两个概念:Shifted Window 是“改变窗口边界、促进跨旧窗口通信”的目标;Cyclic Shift + Mask 是“既保留这个效果,又能规则批处理”的实现方案。
第一步:一维例子,最不容易绕晕
第二行确实让 D 和 E 交流了,但窗口数量从 2 变为 3,边缘窗口只有 2 个 Token。直接填充或者分开计算不够规整。
现在恢复成2 个大小一致的计算窗口了:第一个窗口 C–F 合理;第二个窗口里的 G/H 和 A/B 却只是由于循环移动才被拼在一起,它们在原始图像的左右两端,并不相邻。
Mask 要解决的不是跨旧窗口通信,而是错误的“首尾相连”。 允许 C/D 与 E/F 交流;禁止 G/H 与 A/B 因循环拼接而误连。
第二步:可交互的二维 8×8 模拟
选择「4 · 加上 Mask」,再点网格中的任意一个 Token。绿色描边标出它能关注的位置,红色虚线标出同一计算窗口内被 Mask 屏蔽的位置。
1 · 常规 W-MSA
第三步:Mask 怎样工作?
假设循环移动后的一个窗口是 [G,H,A,B]。它们在计算矩阵里可以放在同一个批次,但不能跨越原图的首尾边界互相注意。
| G | H | A | B | |
|---|---|---|---|---|
| G | 0 | 0 | −∞ | −∞ |
| H | 0 | 0 | −∞ | −∞ |
| A | −∞ | −∞ | 0 | 0 |
| B | −∞ | −∞ | 0 | 0 |
这里 0 表示“这个位置不额外惩罚”,−∞ 表示“在 Softmax 之后权重归零”。实际代码通常用一个足够大的负数(例如 −100)近似;Mask 只限制合法连接,并不会删除 Token。
第四步:为什么要 Reverse Cyclic Shift?
撇号表示Attention 已经更新了特征。反向移动只恢复每个 Token 的空间位置,不撤销信息交互。若不恢复位置,后续的残差相加就会把本不对应的空间位置混在一起。
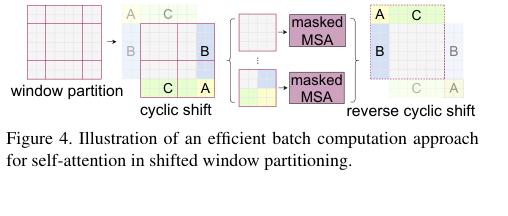
最终口诀:移动窗口是目的;循环位移让窗口保持规则是工程技巧;Mask 切断错误的首尾连接;Reverse Shift 恢复输出坐标。
09|Relative Position Bias:Attention 怎样感知空间位置?
论文第 5 页 §3.2 Relative position bias、公式 (4)。
原始 ViT 将绝对位置编码加到 Token 表示中;Swin 在窗口内的 Attention 分数上加入相对位置偏置 B,体现一对 Token 的相对位移。
比如 E → F 与 D → E 都是“向右一个格子”,因此可使用相同的相对位移偏置参数。不过内容不同,最终注意力权重仍可能完全不同。
互动:选两个位置,查看相对位移
蓝色框为 Query,橙色框为 Key。先点一次设 Query,再点一次设 Key;之后可以不断点击切换。
为什么偏置表是 (2M−1)×(2M−1)?
对于一个 M×M 窗口,沿行方向可以有从 −(M−1) 到 +(M−1) 的相对位移,共 2M−1 种;列方向也一样。
窗口 7×7 → 49 Tokens → 13×13=169 偏置
注意:一个 Head 的完整 Attention 分数矩阵仍然是 49×49;可学习的相对位置偏置表是 13×13。前者包含每对 Token 的关系,后者按相对位移共享参数。两个形状不要混淆。
| 概念 | 作用 | 是否可学习 |
|---|---|---|
| QKᵀ/√d | 内容相关性 | 投影参数可学习 |
| Relative Position Bias(B) | 调整相对位移对应的分数 | 是 |
| Attention Mask | 禁止非法注意力连接 | 否,由窗口位置规则计算 |
误区:相对位置偏置不是人工规定“越近越重要”,而是模型学习不同相对位移的偏好;Mask 则可以强制某些位置的注意力权重为 0,两者作用不同。
10|复杂度公式从哪里来?
论文第 4 页公式 (1)、(2)。下面推导为按论文记号展开的教学解释。论文的 FLOPs 计数省略了 Softmax 等部分计算。
先记号统一:空间网格 h×w,共有 N=hw 个 Token;通道维度 C;窗口边长 M,每窗 M² 个 Token。
第一项:4NC² 来自哪里?
- Q 投影:N×C 输入乘以 C×C 权重,约 NC² 次乘加。
- K 投影:约 NC²。
- V 投影:约 NC²。
- 输出投影:Heads 拼接后还有一次 C→C,约 NC²。
因此两种 Attention 都有相同的4NC²一项。即使只做窗口 Attention,Q/K/V 和输出线性层也不能省掉。
第二项:为什么全局是 2N²C?
- QKᵀ:N 个 Query 与 N 个 Key 相乘,约 N²C。
- 注意力权重乘 V:约 N²C。
合起来约为 2N²C。这就是随着 Token 总数增加的平方项。
第三项:为什么窗口内变成 2NM²C?
一共有 N/M² 个窗口;每个窗口 M² 个 Token,单窗注意力矩阵为 M²×M²,计算 QKᵀ 和乘 V 的成本约 2(M²)²C。
当窗口大小 M 固定时,第二项随 N 线性增长。所以论文称 W-MSA 的复杂度相对于图像 Token 数是线性的。更准确地说:固定 C 与 M 时,该模块总 FLOPs 对 N 线性增长。
代入 Stage 1 的具体数字
| 计算部分 | 全局 MSA | W-MSA |
|---|---|---|
| QKV + 输出线性投影 | 115,605,504 | 115,605,504 |
| 注意力矩阵乘法 + 加权汇总 | 1,888,223,232 | 29,503,488 |
| 两项合计(估算) | 2,003,828,736 | 145,108,992 |
这里取 N=3136、C=96、M=7:注意力混合部分减少 64 倍,但包含线性投影的模块总操作量比约为 13.8 倍;实际速度不能直接从这个数字推出。
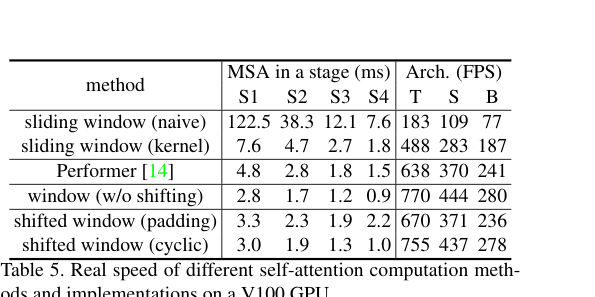
为什么实际 GPU 速度不等于 FLOPs 比例?窗口分组、数据布局、显存访问、张量内核实现、吞吐批量大小等,都会影响真实延迟。论文第 8 页 Table 5 专门测了这些实现差异。
11|Swin-T、S、B、L 有什么区别?
论文第 5 页 §3.3,第 10 页 Table 7。下面 Layer 数是四个 Stage 中的 Swin Block 数量。
| 模型 | Stage 1 通道 C | 各 Stage Block 数 | 各 Stage Heads | 参数量(论文) |
|---|---|---|---|---|
| Swin-T | 96 | 2 / 2 / 6 / 2 | 3 / 6 / 12 / 24 | 29M |
| Swin-S | 96 | 2 / 2 / 18 / 2 | 3 / 6 / 12 / 24 | 50M |
| Swin-B | 128 | 2 / 2 / 18 / 2 | 4 / 8 / 16 / 32 | 88M |
| Swin-L | 192 | 2 / 2 / 18 / 2 | 6 / 12 / 24 / 48 | 197M |
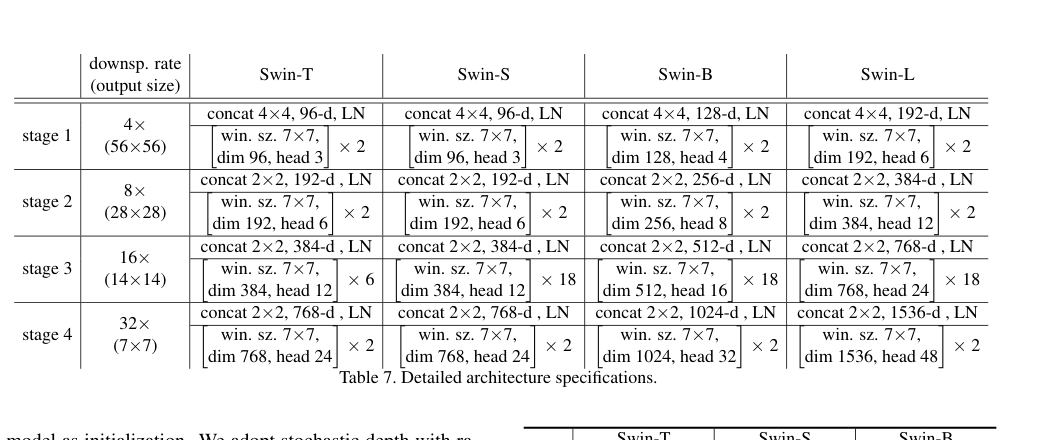
共同点:默认 7×7 Window、每个 Head 维度 d=32、MLP 扩展比例 4。不同规模主要通过第一阶段通道宽度 C和第三阶段 Block 数量调节。
例如 Swin-S 和 Swin-T 都从 96 通道开始,但 Stage 3 的 Block 数由 6 增至 18;Swin-B 则进一步加宽通道。
读模型配置时先看:每个 Stage 的 深度(Blocks)、宽度(Channels)和 Heads,再看参数与 FLOPs,而不只是 T/S/B/L 的命名。
12|实验到底证明了什么?
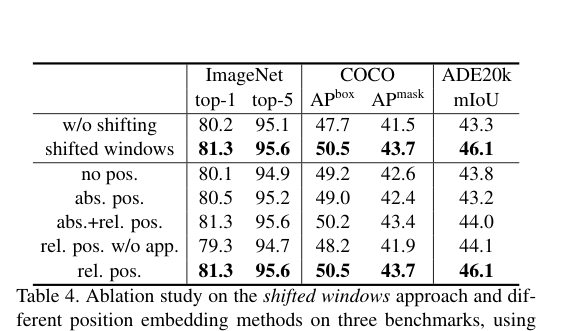
论文第 6–9 页 §4,尤其 Table 1、2、3、4、5、6。下列是 2021 年论文中的报告结果,不代表后续最新榜单。
三个任务、三个指标体系
| 任务 | 数据集 | 指标 | 读实验时关注什么 |
|---|---|---|---|
| 图像分类 | ImageNet-1K | Top-1 Accuracy | 预测类别是否正确 |
| 目标检测 / 实例分割 | COCO | Box AP / Mask AP | 定位框和实例掩码的质量 |
| 语义分割 | ADE20K | mIoU | 像素级语义分割的一致性 |
消融 1:Shifted Window 真的有用吗?
| Swin-T 配置 | ImageNet Top-1 | COCO Box AP | ADE20K mIoU |
|---|---|---|---|
| 所有层固定窗口(不 shift) | 80.2 | 47.7 | 43.3 |
| 正常 Swin(shifted windows) | 81.3 | 50.5 | 46.1 |
| 增益 | +1.1 | +2.8 | +2.8 |
结果支持作者的解释:不同窗口之间建立联系能够提升多个任务的表现。(来源:论文第 8 页 Table 4)
消融 2:相对位置偏置有用吗?
| 位置方案 | 分类 Top-1 | COCO Box AP | ADE20K mIoU |
|---|---|---|---|
| 不加位置编码 / 偏置 | 80.1 | 49.2 | 43.8 |
| 绝对位置编码 | 80.5 | 49.0 | 43.2 |
| 相对位置偏置 | 81.3 | 50.5 | 46.1 |
效率实验:为什么 Figure 4 不只是“数学花活”?
Table 5 在相同论文测试环境下比较 直接 padding 和 cyclic shift 的真实吞吐量。对 Swin-T,论文报告 670 → 755 images/s;对于 Swin-S,为 371 → 437 images/s,说明工程实现策略也影响运行效率。
读整体结果时要防止不公平比较
ImageNet 分类 Table 1(a):224²、常规 ImageNet-1K 训练下,Swin-T 81.3%,DeiT-S 79.8%。不过两者吞吐也不同,不能只说 Swin 在所有维度都更快。
COCO / ADE20K 论文报告 Swin-L 的系统级最好结果包括 58.7 Box AP、51.1 Mask AP;ADE20K 验证集 mIoU 53.5。这些结果使用更大模型、预训练和特定任务头及测试策略。
科学阅读方法:看论文不是只看最佳数字。对于跨模型比较,检查 数据集、预训练、输入尺寸、检测/分割头、训练轮数、测试增强是否一致;对核心模块是否有效,优先看控制变量的消融实验。
13|把论文映射到 PyTorch 代码
以下是教学级简化示例,帮助你检查张量维度。不是从作者仓库复制的完整模型;生产代码还需要 batch、padding、不同 Head、position bias、DropPath 等处理。
1. Patch Partition 和 Linear Embedding
Python / PyTorch · 只展示核心形状
import torchimport torch.nn as nn
# PyTorch 的图像张量通常是 [batch, channel, height, width]x = torch.randn(1, 3, 224, 224)
# kernel_size = stride = 4,可同时完成 Patch Partition + Linear Embeddingpatch_embed = nn.Conv2d(3, 96, kernel_size=4, stride=4)y = patch_embed(x) # [1, 96, 56, 56]y = y.permute(0, 2, 3, 1) # [1, 56, 56, 96]print(y.shape)这里用 Conv2d(kernel=4, stride=4) 实现的是一种等价的线性 Patch Embedding:每个不重叠 4×4 Patch 投影到 96 维。这不意味着之后整个 Swin 使用卷积替代 Attention。
2. 最小版 Patch Merging
Python / PyTorch · 适用于偶数高宽
import torchimport torch.nn as nn
x = torch.randn(1, 56, 56, 96) # [B, H, W, C]x0 = x[:, 0::2, 0::2, :] # 左上x1 = x[:, 1::2, 0::2, :] # 左下x2 = x[:, 0::2, 1::2, :] # 右上x3 = x[:, 1::2, 1::2, :] # 右下
x = torch.cat([x0, x1, x2, x3], dim=-1)print(x.shape) # [1, 28, 28, 384]
reduction = nn.Linear(4 * 96, 2 * 96)y = reduction(x)print(y.shape) # [1, 28, 28, 192]3. 最小版 Cyclic Shift 与 Reverse Shift
Python / PyTorch
import torch
x = torch.arange(8 * 8).reshape(1, 8, 8, 1)shift = 2
# 向上、向左循环移 2 格shifted = torch.roll(x, shifts=(-shift, -shift), dims=(1, 2))
# 这里应在 shifted 上执行 window partition + masked attention# attended = window_attention(shifted, attention_mask)
# 为了验证“先移后还原”不改变空间顺序,此处仅演示逆操作restored = torch.roll(shifted, shifts=(shift, shift), dims=(1, 2))assert torch.equal(restored, x)注意:如果中间执行了真正的 Attention,恢复后的数值不会再与原始 x 相同;这里的断言只用于验证 torch.roll 正反移动的排列规则。
4. 一个可以自己运行的 Mask 构造思路
Python / PyTorch · 8×8 网格,4×4 Window,shift=2
import torchH = W = 8M = 4S = 2
# 按“循环移动后的坐标”给来源区域编号:# [0:4] / [4:6] / [6:8] 沿两个轴各划成三段region = torch.zeros((H, W), dtype=torch.long)row_slices = [slice(0, H - M), slice(H - M, H - S), slice(H - S, H)]col_slices = [slice(0, W - M), slice(W - M, W - S), slice(W - S, W)]count = 0for rs in row_slices: for cs in col_slices: region[rs, cs] = count count += 1
# [8, 8] --> [2, 4, 2, 4] --> [4, 16]window_ids = region.reshape(H // M, M, W // M, M)window_ids = window_ids.permute(0, 2, 1, 3).reshape(-1, M * M)
# 同一计算窗口内:不同来源区域需 Mask# [4, 16, 16] True 表示禁止注意力连接mask = window_ids[:, :, None] != window_ids[:, None, :]print(mask.shape) # torch.Size([4, 16, 16])
# 如果 attn_logits 是 [B*num_windows, heads, 16, 16]# 应先正确对齐每个 window 的 mask,再 masked_fill;# 不可未经检查地把 [4, 16, 16] 直接广播到任意 batch。完整 SW-MSA 还要计算 Q/K/V、加入每个 Head 的相对位置偏置、应用 Mask、合并 Heads 和窗口,再做反向循环移位。真正的训练实现还会处理输入尺寸不能整除窗口的情况。
建议实操顺序:先打印 Patch Merging 各步 shape,再用 8×8 的整数网格打印 roll 前后的位置,最后检查 Mask 中哪些位置为 True。确认这些都理解后,再看官方源码。
官方实现可查阅 microsoft/Swin-Transformer。
14|把容易混淆的概念一次理清
| 容易说错的说法 | 更准确的理解 |
|---|---|
| “Shifted Window 就是把整张图随便挪一下” | 目标是改变窗口覆盖范围;Cyclic Shift 只是高效实现这种新窗口划分的手段。 |
| “Mask 用来阻止跨窗口交流” | Mask 只禁止循环拼接造成的非法连接;合法的跨旧窗口交流需要被保留。 |
| “Reverse Shift 撤销了 Attention” | 只恢复位置排列,Token 的新特征保留。 |
| “Stage 里每个 Block 都减少分辨率” | Stage 内 Block 一般不改变 H/W/C;Patch Merging 才进行下采样。 |
| “MLP 负责不同 Token 相互交流” | 逐 Token MLP 负责通道特征的非线性变换,跨 Token 信息交互主要由 Attention 完成。 |
| “49×49 Attention = 169 个参数” | 注意力矩阵和位置偏置表不是同一个对象;7×7 Window 对应 49×49 分数矩阵、13×13 相对位置偏置表。 |
| “注意力 FLOPs 降低 64 倍,网络就快 64 倍” | 投影、MLP、内存访问等没有被同样比例缩减,真实吞吐需实际测试。 |
| “做完一对 Block 就得到全局信息” | 局部信息是靠堆叠交替窗口逐层传播,不能当成单层全局 Self-Attention。 |
15|用 6 道题确认自己是不是理解了
选择答案后点击「批改」。六道题覆盖张量形状、窗口机制、计算复杂度与消融实验。
16|下一次打开手册时,按这个清单学习
这些勾选项在同一个浏览器中会自动保留(使用本地存储);清除浏览器网站数据后可能丢失。它只是个人学习检查清单,不等于系统确认你已经掌握。
阶段性目标:如果能独立讲清 “固定窗口为什么不够、移动窗口怎样建立跨窗口联系、为什么循环移动必须配 Mask、为什么最后要移回”,就真正抓住了这篇论文最重要的技术链条。
17|术语表、论文页码与出处
| 术语 | 含义 |
|---|---|
| Backbone · 骨干网络 | 负责提取视觉特征,后面可以接分类、检测或分割任务头。 |
| Token · 特征单元 | 在 Swin 中通常对应当前尺度特征图的一个空间位置。 |
| Stage · 阶段 | 同一空间分辨率下的一组 Swin Blocks。 |
| Patch Merging · 合并 | 相邻 2×2 Token 拼接后投影到 2C,降低空间分辨率。 |
| W-MSA · 窗口多头注意力 | 在固定且不重叠的局部窗口内部计算 MSA。 |
| SW-MSA · 移动窗口注意力 | 移动窗口划分,连接原窗口边界附近的 Token。 |
| Cyclic Shift · 循环移位 | 越界的 Token 从另一侧接入,便于固定形状计算。 |
| Attention Mask · 掩码 | 在 Softmax 前禁止人工拼接形成的非法注意力连接。 |
| Relative Position Bias · 相对位置偏置 | 按 Query 与 Key 的相对位移调整 Attention 分数。 |
| mIoU / AP / Top-1 | 分别是语义分割、检测及分类任务的常用评价指标。 |
按论文位置回读
| 章节 / 图表 | PDF 页码 | 对应本手册 |
|---|---|---|
| Abstract / Introduction / Figure 1 | 1–2 | 第 01 章 · 研究动机 |
| Figure 2 | 2 | 第 07 章 · Shifted Window |
| §3.1 / Figure 3 | 3–4 | 第 03–05 章 · 架构与 Block |
| §3.2 / Eq. (1)(2)(3) | 4 | 第 06、07、10 章 |
| §3.2 / Figure 4 / Eq. (4) | 5 | 第 08、09 章 |
| §3.3 / Table 7 | 5 / 10 | 第 11 章 · 模型变体 |
| §4 / Tables 1–6 | 6–9 | 第 12 章 · 实验分析 |
| Appendix A1, A2, A3 | 9–11 | 架构配置、训练细节和补充实验 |
论文完整信息:Ze Liu, Yutong Lin, Yue Cao, Han Hu 等,Swin Transformer: Hierarchical Vision Transformer using Shifted Windows,arXiv:2103.14030v2,2021。arXiv 论文页。这里的原论文图片均从论文 PDF(arXiv v2,共 14 页) 中裁取;所有其他图表与交互为教学重制。