

把 I love cats 翻成 我喜欢猫 时,模型先要读懂英文。等中文已经生成到「我喜欢」,它还要判断下一个位置该放什么。前一个问题允许模型看完整的英文,后一个问题只有英文和已经生成的中文可以用。理解原版 Transformer,可以从这两个位置的可见范围开始。
第一篇学习笔记 从 Token 追到 Q/K/V,推导了为什么点积要除以 ,也比较了一个宽头和多个窄头。这一篇把它们放回 Vaswani 等人在 2017 年提出的 Encoder–Decoder 架构,沿着同一句翻译读完训练、生成和实验,再亲手实现一个能跑的小模型。
正文的手算、分词和玩具训练都标为教学示例。论文配置和实验结果会注明出处,图表采用 NeurIPS 2017 会议版。 官方论文 PDF
手算注意力 · 看 Decoder 的两种注意力 · 读论文实验 · 运行代码 · 综合自测 · 课后大题
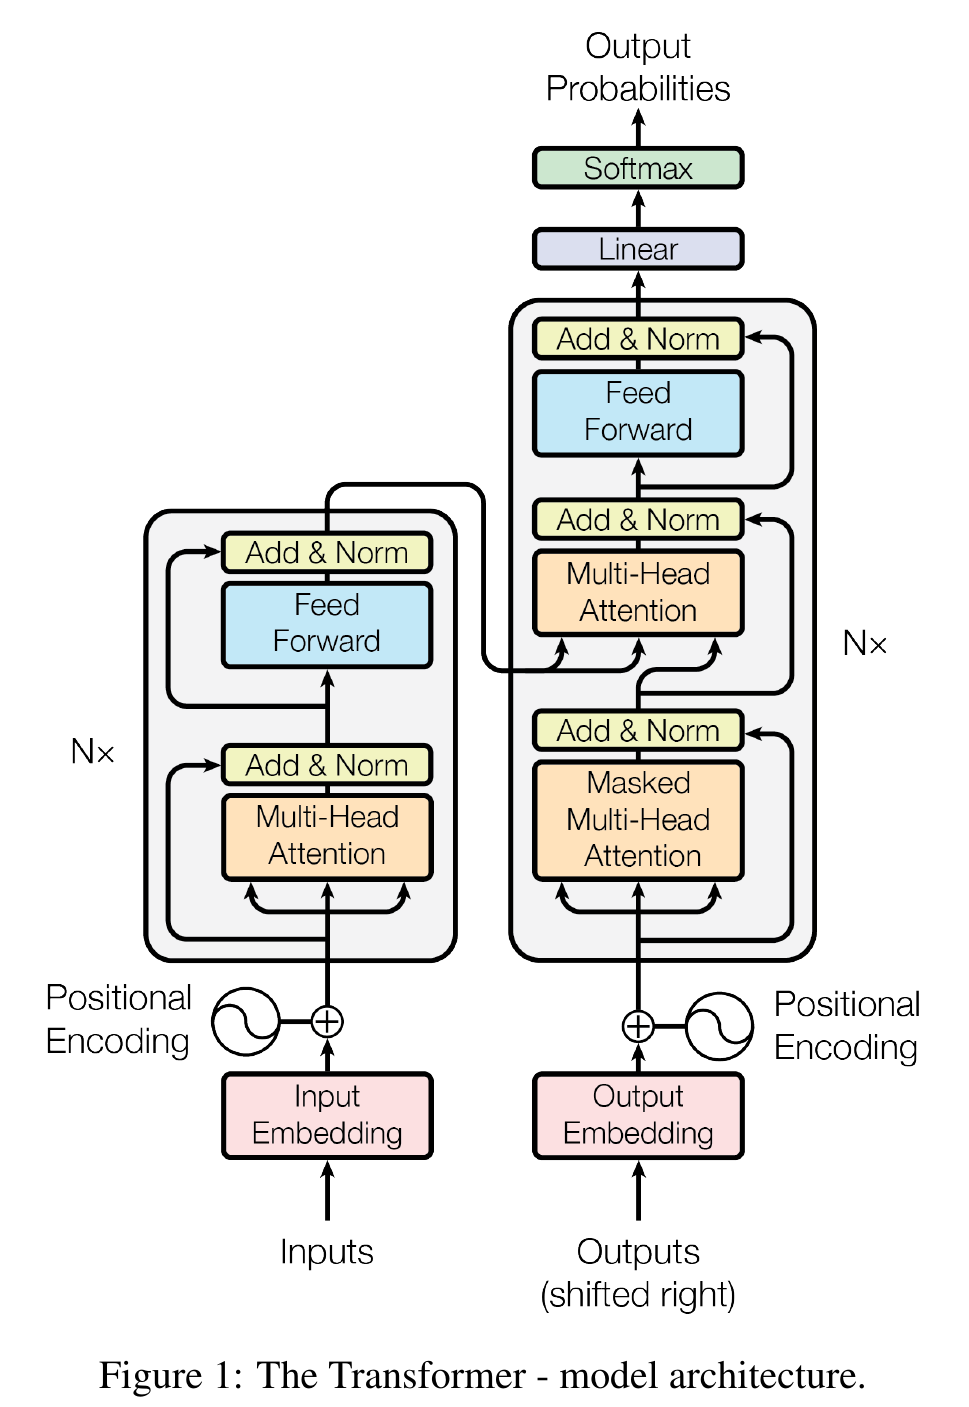
先读图底和中间两处。左下角的 Inputs 是源序列,右下角的 Outputs (shifted right) 是右移目标序列。顺着左侧最上方横跨到右侧的线,可以看到 Encoder 的输出进入 Decoder 中间的注意力模块。后面读 Decoder 时,重点就落在这条线送来什么,以及它和右下角的序列如何配合。
00|序列为什么能写成一张矩阵
假设 Tokenizer 把「I love cats」编成三个 Token,词表大小为 ,Embedding 宽度选 4。词表负责把 Token 映射为 ID,Embedding 表 负责把 ID 映射为向量。取出三个 ID 对应的三行,就得到一张 的输入矩阵。词表里可供选取的行数与一次选出的行数分别是 和 3。
这是便于手算的教学矩阵。三行依次对应 I、love、cats,四列对应四个特征。Linear 层可以用同一套权重改写每行的特征。ReLU 把负数截成 0,为两次线性变换之间引入非线性。Residual 把子层输入加回输出,保留一条直达路径。LayerNorm 在单个位置的特征轴上计算均值和方差,再做可学习的缩放与平移。
后面会频繁遇到两种乘法。 沿特征轴做线性投影,通常保留位置数。 逐对比较 Query 和 Key,结果的一行是一条 Query 对所有 Key 的分数。Softmax 沿这一行的 Key 轴归一化,让它成为当前查询的权重分配。
自测|位置轴、特征轴和词表
- 是 、 是 , 是什么形状?。每个 Query 都和四个 Key 做一次长度为 2 的点积。
- 对分数矩阵逐行做 Softmax,每行和是多少?1。每行至少要有一个可见且有限的分数。
- 为什么一个 Token 的向量长度可以远小于词表大小?Embedding 取的是表中的一行,词表大小决定行数,向量宽度由模型设定。
01|Transformer 想绕过哪一条顺序依赖
在 Seq2Seq 翻译中,Encoder 接收源句,Decoder 在源句表示和译文前缀的条件下预测目标 Token。传统 RNN 的一个位置用 更新隐藏状态。即使训练时已知整句英文,也要先有 才能算 。LSTM 改进了信息怎么沿时间传递,计算仍然依赖前一个时间步。
Self-Attention 让 love 在同一层里直接与 I 和 cats 的表示匹配。只要这一层的输入都已准备好,同层各位置的 Q/K/V 投影和点积就可以批量计算。源句中的信息因此不必按词依次传递。训练时目标前缀也已知,可以一次算出它的各位置。推理时生成前缀本身仍有依赖,生成「喜欢」之后,下一步才拿得到它。论文主要用 WMT 2014 英德、英法机器翻译检验架构。 原论文 §1–2
自测|训练能并行,为什么还要逐步翻译?
- RNN 同层多个位置在训练时为何相互等待? 的计算直接读取 。
- Transformer Decoder 为什么仍然通常逐 Token 生成?下一步的真实输入来自模型上一步生成的 Token。
- 论文用什么任务验证架构?以 WMT 2014 英德和英法机器翻译为主,另报告英语成分句法分析。
02|Attention 怎样查找并汇总信息
如果在更新 love 的表示,可以把它的 Query 当作这次匹配使用的特征,把三个位置的 Key 当作待比较的特征。每个 Key 都有一条对应的 Value。算出分数并归一化后,用权重汇总的是 Value。这样匹配所需的表示和实际传回的内容就可以分别学习。
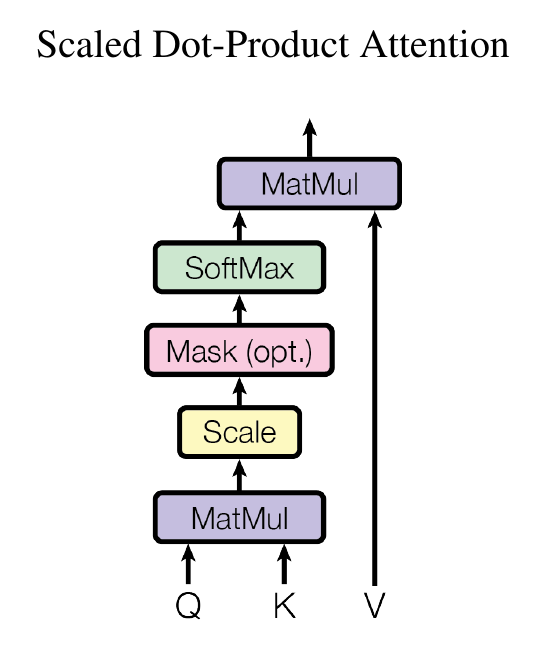
先找最下面和最上面的两个 MatMul。下面一个只接 Q 与 K,算出位置对之间的匹配分数。沿右侧的 V 往上看,它直到上面一个 MatMul 才进入计算。这时分数已经过 Softmax,V 提供的是加权求和用的内容。
在同一层的 Self-Attention 中,、、 都读同一份 ,三套投影分别学习。一个较大的权重意味着当前这一步汇总更看重对应的 Value,但预测还受 Value、其他头、输出投影和后续层影响。要论证某个 Token 对最终预测的因果作用,还需要干预或对照。
自测|追踪一行 Query
- 为什么最后乘 V?K 决定匹配分数,V 提供该位置实际参与求和的特征。
- 为什么 love 的输出能包含 cats 的信息?cats 的 Value 可以在这行加权和中占有非零权重。
- 一行注意力权重应该满足什么性质?对于有可见位置的行,权重非负,行和为 1。被屏蔽的 Key 权重为 0。
03|缩放点积注意力怎样手算一遍
设 Query 有 个位置,Key 和 Value 共用 个位置。 是 Query 与 Key 的特征宽度, 是 Value 的特征宽度。按第 02 章的路径,先算每对 Q、K 的点积,再决定哪几个位置可以参与汇总。 原论文 §3.2.1,式(1)
| 步骤 | 形状 | 读法 |
|---|---|---|
| 点积 | 一行查全部 Key | |
| 缩放 | 每个分数除以 | |
| 可选 Mask | 表示允许, 表示禁止 | |
| Softmax | 每个 Query 的权重沿 Key 轴和为 1 | |
| 加权求和 | 每个 Query 得到一条 维向量 |
缩放的出发点是控制分数的波动。在分量相互独立、均值 0、方差 1 的简化模型中,点积方差为 ,标准差为 。除以 可以稳定分数的典型尺度,缓解维度增大带来的 Softmax 饱和。真实的 Q/K 分布会随模型、层和输入变化。 第一篇的方差推导与数字对照
手算一个 Query,两条 Key
令 、、,、。这是一组教学示例,暂时允许 Query 看见两个位置。
- 点积给出 。第一条 Key 与 对齐,第二条与 正交。
- ,因此缩放后的分数是 。
- Softmax 权重为 。
- 输出是 。形状是 。
如果只允许看第一条 Key,分数变成 ,权重变成 ,输出随之变为 。
import mathimport torch
q = torch.tensor([[1.0, 0.0]])k = torch.tensor([[1.0, 0.0], [0.0, 1.0]])v = torch.tensor([[2.0, 0.0], [0.0, 4.0]])scores = torch.matmul(q, k.T) / math.sqrt(q.shape[-1])weights = torch.softmax(scores, dim=-1)out = torch.matmul(weights, v)assert out.shape == (1, 2)torch.testing.assert_close(out, torch.tensor([[1.339523, 1.320954]]))自测|沿哪条轴归一化?
- 为什么沿 Key 轴做 Softmax?每个 Query 都要独立决定自己从哪些 Key 对应的 Value 取信息。
- 为什么宽度翻四倍时分母只翻两倍?在推导的假设下,方差随宽度线性增长,标准差取方差的平方根。
- Q 的位置数可以和 K/V 不同吗?可以。每个 Query 都匹配全部 Key。K 和 V 的位置数须相同,才能把权重乘到对应的 Value 上。
04|为什么要把注意力分成多个头
一个头为每个查询位置算出一套位置权重,再用这套权重聚合该头的全部 Value 通道。多个头拥有各自的投影,所以能为同一个查询位置分别选择位置权重。比如某个头给 I 较高权重,另一个头给 cats 较高权重,最后再融合两份信息。这里的分工只用于说明机制,训练出来的头可以有相似的权重分布。
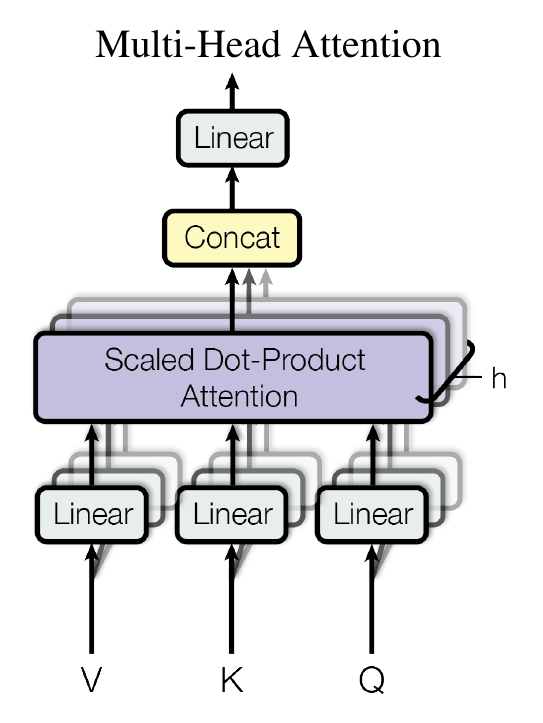
看图底重叠的 Linear 和中间重叠的 Scaled Dot-Product Attention,每一层叠片代表一套投影和汇总。最上面的 Concat 把各头的特征并排放好,最后一个 Linear 用新的权重混合这些特征。若在代码中一次投影出所有头,再拆开最后一维,拆分的是投影后的结果。
上式写的是 Self-Attention。在论文 Base 配置下,、,每头 。三个位置的输入是 ,每头的 、、 都是 ,每头权重是 ,每头输出是 。沿特征轴拼接得到 ,再右乘 的 ,可在列之间做跨头的线性混合,输出仍然是 。 原论文 §3.2.2
自测|从八个头变成十六个头
- 八个头共用一套 Q/K/V 参数吗?它们有各自的参数,即使实现时将参数存进同一个大矩阵。
- 拼接已经凑够 512 维, 还有什么用?拼接保留各头通道,输出投影可以用多个头的通道共同构造新的每个特征。
- 总宽保持 512,平均分 16 个头,每头多少维?32。每头仍为三个查询位置各算一组权重。
05|没有循环,顺序从哪里来
如果只看全可见的 Self-Attention,并且输入里没有任何位置信息,交换 I 与 cats 两行,输出也只是交换相应两行。设 为换行的置换矩阵,逐行投影使 、、 分别变成 、、。分数矩阵变成 ,因此逐行 Softmax 后,行和列也一同置换。最终的输出是 。这种性质叫置换等变。这里分析的是无位置相关掩码的情况。
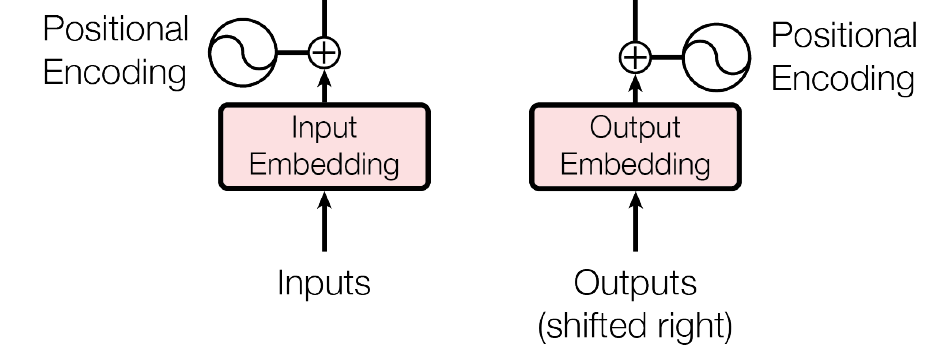
看两个 ⊕。源端和目标端都先查 Embedding,再把同宽的位置向量加进去。这样矩阵形状维持在 ,后面的投影从数值里同时读到词和位置,Attention 的公式也可以原样使用。论文对正弦和余弦成对使用同一频率。 数序列位置, 数频率对的编号。 原论文 §3.5
四维位置编码的手算
取 ,第一对频率的角度是 ,第二对是 。前一对在相邻位置之间变化明显,后一对变化较慢。
| 位置 | 第一对 | 第二对 |
|---|---|---|
| 0 | ||
| 1 | ||
| 2 |
对任意一个频率 ,记 。位置向后移 时,角度统一加上 。根据和角公式,可以用一个只取决于偏移量的线性变换表示新的位置向量。
作者据此推测模型较容易学习相对偏移,也可能外推到训练中未见的长度。表 3 的学习位置向量对照是在指定开发集上做的比较,任意长度外推仍需要单独验证。 原论文 §3.5
自测|位置信息怎样到达分数矩阵?
- 与 各指什么? 是 Token 位置, 是成对的正弦和余弦通道编号。
- 为什么 PE 与 Embedding 同维?它们按对应位置和特征逐项相加。
- PE 在哪里改变分数?它先参加 ,再经 、 改变 Q/K,最后改变 。
06|Encoder 怎样让三个词互相提供上下文
进入 Encoder 的每个位置都是词向量与位置向量之和。每层先做全源句的 Self-Attention,再对更新后的每个位置做 FFN。原论文把这种结构堆叠 6 层。每层结构一致,各层参数各自学习。 原论文 §3.1、§3.3
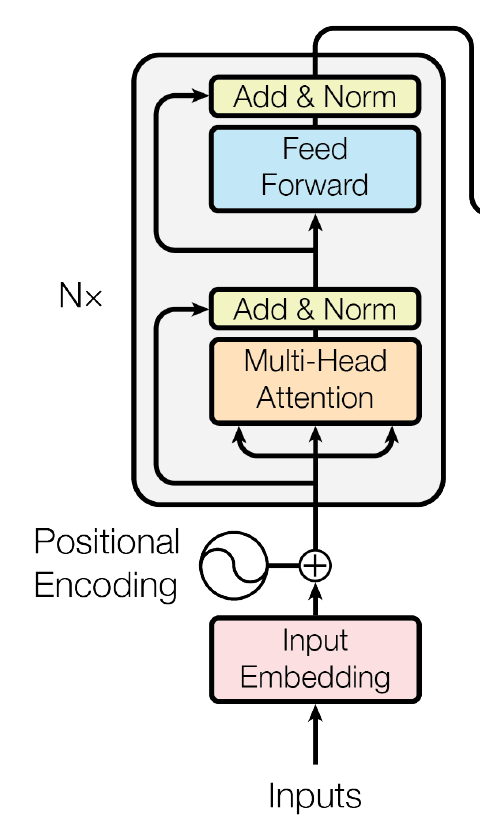
顺着左边的三个输入箭头看。橙色块的 Q/K/V 都来自同一层的输入。两个绕过子层的外侧箭头是残差,走到黄色 Add & Norm 时再与子层结果相加。蓝色的 Feed Forward 对每个位置独立使用同一套层内参数。
LayerNorm 位于残差相加之后,这一顺序称为 Post-LN。在 Base 中,FFN 对每个位置做 ,中间用 ReLU。以三个源位置为例,FFN 的中间形状是 ,相加前回到 。因此位置数保持为 3,变化的是每一行的内容。Encoder 最终输出 ,供 Decoder 使用。
自测|分清注意力和 FFN 的职责
- 为什么 FFN 不直接交换 Token 间的信息?同一套 FFN 分别作用在每行,每行的计算只读取自己的输入。
- 残差相加为什么要求维度一致?对应位置和特征需要一一相加,所以 FFN 最后一层投回模型宽度。
- 六个 Encoder Layer 参数完全共享吗?各层有各自的参数。共享发生在同一层的 FFN 对不同位置应用同一函数时。
07|Decoder 为什么需要两种注意力
在生成「猫」之前,Decoder 已经有开头标记和「我 喜欢」。它首先在这段中文内部更新每个位置,再拿更新后的中文表示去查英文。前一次汇总回答「中文已说了什么」,后一次回答「当前要从英文取什么」。 原论文 §3.1、§3.2.3
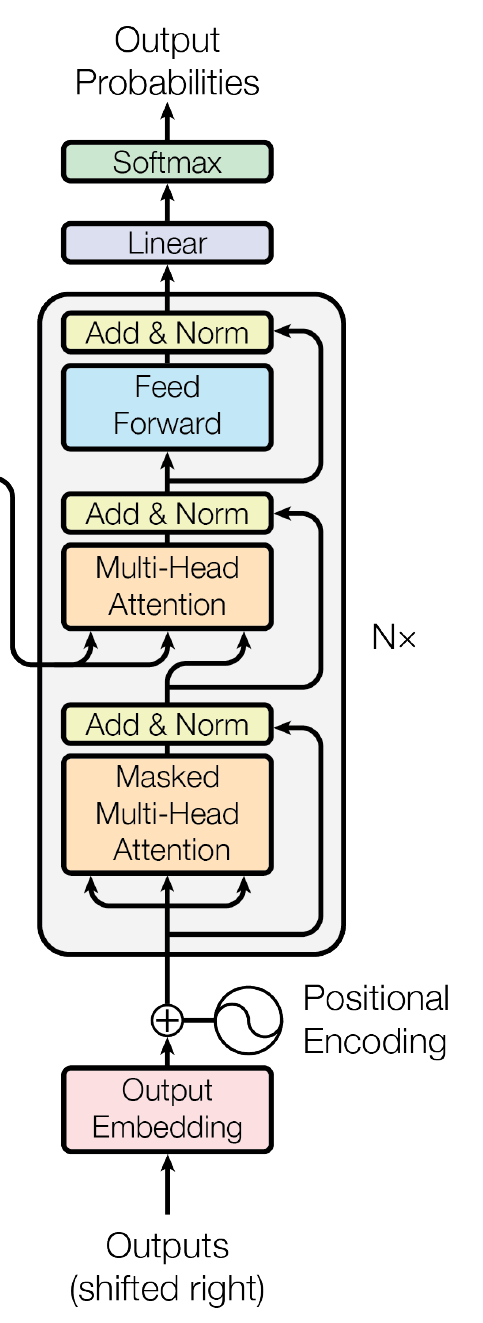
读图时先看两个橙色块。下方的 Masked Multi-Head Attention 三条线都来自目标序列。中间的 Multi-Head Attention 有两路从左侧进入,它们把 作为 K、V 的输入。来自下方 Decoder 的那一路提供 Q。这两块各自有 Add & Norm,最后还有一个 FFN 和 Add & Norm。原版 Decoder 也堆叠 6 层,每层都能读取最终 Encoder 表示。
| 注意力 | Q 来自 | K/V 来自 | 可见范围 |
|---|---|---|---|
| Encoder 自注意力 | 当前层的源位置 | 同一份源表示 | 全部有效源位置 |
| Decoder 掩码自注意力 | 当前层的目标位置 | 同一份目标表示 | 当前及之前的有效目标位置 |
| Encoder–Decoder 交叉注意力 | Decoder 的中间状态 | Encoder 最终输出 | 全部有效源位置 |
因果掩码长什么样
行是目标查询位置,列是目标 Key 位置。用加性掩码时,允许的位置加 0,禁止的位置加 ,Softmax 后后者的权重为 0。
例如索引 2 的查询只允许看 0、1、2。这个三角掩码规定的是目标序列内的时间顺序。Padding mask 则负责去掉批处理中补齐的空位置,两者可以同时生效。
交叉注意力可以是长方形。若源句有 个位置,目标前缀当前有 个位置,则 Base 的每个头用 匹配 ,得到 的权重矩阵。乘 的 V 得到 。拼接八头之后还保留两个目标位置,输出宽度为 512。
自测|三种注意力各从哪里取数据?
- 画出 因果掩码。用上面的矩阵核对,行 对 的列赋 。
- 为什么交叉注意力的 Q 来自 Decoder?由当前译文状态决定该查英文的哪些位置,英文表示提供 K 和 V。
- 为什么不能直接用 Encoder 输出当 Decoder 输入?Decoder 输入承担「已知译文前缀」这一条件,需要在目标位置上形成查询,它与源序列在长度和作用上都可以不同。
08|同一句话在训练和生成时怎么走
这次明确规定教学分词。源句是 I / love / cats,译文是 我 / 喜欢 / 猫,另用 BOS 表示开始、EOS 表示结束。Encoder 先读入三个英文 Token 得到 。训练和生成都让目标端查询同一个 ,区别在于已知的目标前缀从哪里来。
训练时,一次预测四个位置
| 位置索引 | 0 | 1 | 2 | 3 |
|---|---|---|---|---|
| 喂给 Decoder | BOS | 我 | 喜欢 | 猫 |
| 要预测的标签 | 我 | 喜欢 | 猫 | EOS |
索引 2 的输入是「喜欢」,标签是「猫」。用上一章的因果掩码,这一行可以读到 BOS、我、喜欢。虽然「猫」在同一个输入矩阵的下一行,掩码会阻断这一行读取它的路径。所有位置的输入在训练时已经准备好,因此可以一次计算四行 logits,每行按照自己的可见范围汇总信息。这就是 Teacher Forcing 下的右移。
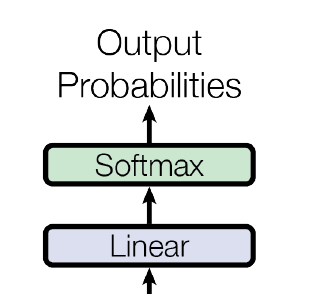
看最上方的 Linear → Softmax。每个目标位置的表示有 512 维,Linear 把它投影成 个 logits,每个目标词表项一个分数。这里 Softmax 归一化的是词表轴。注意力内部的 Softmax 归一化的是 Key 的位置轴。训练时交叉熵可以直接读取 logits,由损失函数内部完成 log-softmax。
生成时,把上一步的输出接到前缀
- 用 BOS 和 求下一 Token 的分布,取出「我」。
- 用 BOS、我 和 预测「喜欢」。
- 继续得到「猫」,再生成 EOS,结束。
这是模型每步都选对的教学示例。真实推理只能使用已生成的前缀,一次选错也会改变后续输入。源句没变, 可以复用。完整模型一次走过哪些模块,可以对照篇首的架构总图。 原论文 §3.4
自测|下一词概率从哪里来?
- 训练已经知道译文,怎么防止标签泄漏?依靠输入右移和每层因果掩码。对第 个标签而言,该标签在右移输入的未来位置。
- 为什么 可以多步复用?它只依赖同一条源句。
- 为什么输出最后一维是词表大小?每一行要为所有候选下一个 Token 各给一个分数。
09|模型怎样从预测里学到参数
训练从右移输入得到 logits,在每个有效目标位置计算交叉熵。以普通的 one-hot 标签为例,目标词概率为 时,该位置的损失是 。整句损失可以在有效位置上取平均,补齐用的 PAD 不计入。模型的 Q/K/V 投影、Embedding、FFN 和其他权重沿这条损失的梯度一起更新。
原论文训练设置沿哪条路径起作用
| 设置 | 在哪里起作用 | 论文配置或用意 |
|---|---|---|
| 参数共享 | 输入 Embedding、输出 Embedding 和词表投影 | §3.4 描述共享权重矩阵。词表投影可用转置,Embedding 侧另乘 |
| Adam | 梯度算出之后 | 、、 |
| Warmup | 每一步的学习率 | 前 4,000 步线性升高,之后按步数平方根的倒数衰减 |
| Dropout | 子层输出加回残差之前,以及 Embedding 与位置编码之和 | Base 的比率为 0.1 |
| Label Smoothing | 交叉熵中的目标分布 | ,把少量目标概率分给其他候选。作者报告 PPL 变差,同一设定下准确率和 BLEU 改善 |
| Beam Search | 推理期间保留多个候选前缀 | Beam size 为 4,长度惩罚系数 |
如果共享的 Embedding 矩阵写作 ,输入可以按 ID 取一行,输出可以把隐藏表示右乘 得到词表分数。共享源端和目标端要求索引与词表兼容。原论文英德训练使用约 450 万个句对和约 37,000 项的共享 BPE 词表,按近似长度组织批次。报告中的 Base 在 8 张 P100 上训练 100,000 步,约 12 小时。Big 训练 300,000 步,约 3.5 天。这些耗时属于论文的硬件和配置。 原论文 §3.4、§5 与 §6.1
设 是从 1 开始的步数,。学习率公式中的两个候选值恰好在 相交。
当 ,第二项更小,学习率随 线性增加。当 ,第一项更小,学习率随 下降。用 Base 的 512 维计算,第 4,000 步峰值约为 。Label Smoothing 改的是目标分布,Beam Search 改的是解码时搜索的候选。它们分别在损失和推理环节发挥作用。
自测|分清优化、损失和解码
- Warmup 前后怎么变化?4,000 步前取随步数线性增长的一支,之后取平方根倒数衰减的一支。
- Label Smoothing 为什么会改变学习效果?目标分布更平滑,训练不再要求把所有目标概率都压到一个词上。
- Teacher Forcing 和生成的输入有何区别?训练前缀来自真实译文,生成前缀由模型自己产生。
10|Self-Attention 的优势与代价是什么
论文比较了三件事。计算复杂度数一层要做多少工作,顺序操作数数有多少步骤相互等待,最长路径取所有位置对之间信息传递路径长度的最大值。并行性来自第二项,远位置能否在同一层连接来自第三项。
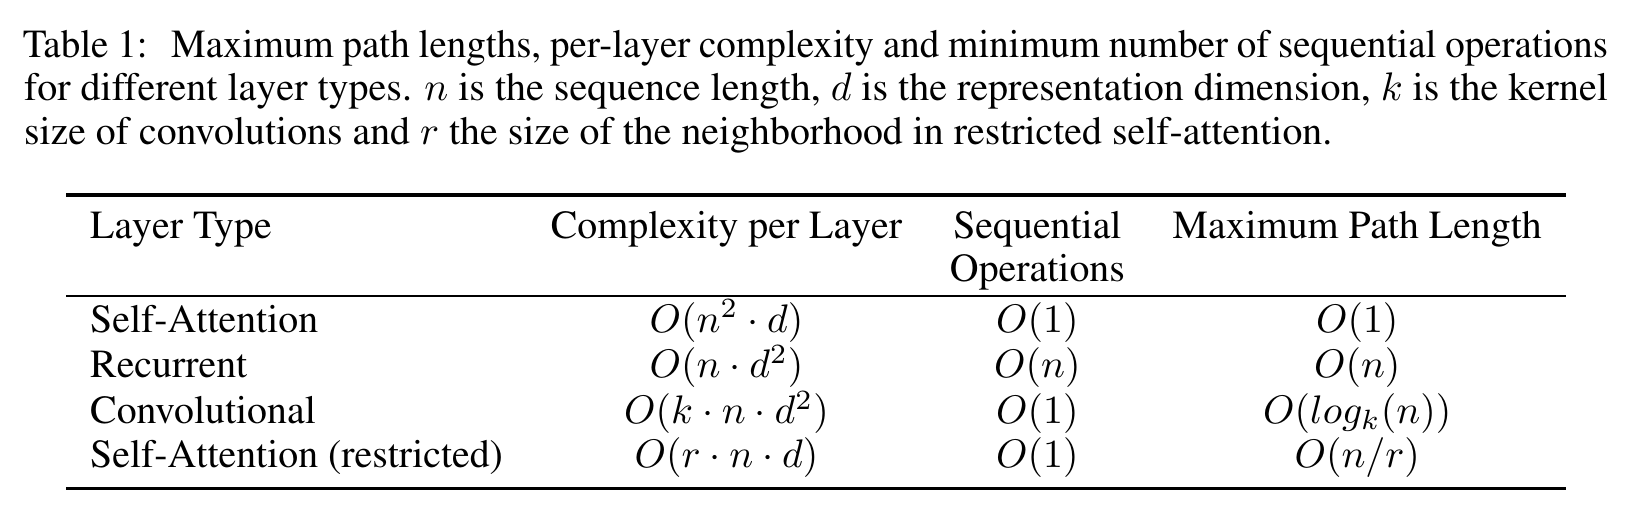
先看原表的 Self-Attention 行。它在顺序操作与最长路径两列都是 ,计算量是 。一个查询直接与所有 Key 匹配,故路径短。总共要匹配 对,故工作量随长度二次增长。再看 Recurrent 行,逐位置传递导致 的顺序操作和最长路径。
| 层类型 | 每层计算量 | 顺序操作 | 最长路径 |
|---|---|---|---|
| 全局 Self-Attention | |||
| 循环层 | |||
| 卷积层 | |||
| 局部 Self-Attention |
是序列长度, 是表示宽度, 是卷积核宽度, 是受限注意力的邻域大小。卷积的对数路径对应论文讨论的空洞卷积。表里的注意力项描述位置两两匹配与汇总,完整多头层还要算投影,Encoder 和 Decoder 也有 FFN。以 为例,仅比较表中两项有 。 超过 后这个不等式反转。若为每个头显式保存 的权重,序列长一倍,权重元素数就增为四倍。实际耗时还取决于内存、硬件和实现。 原论文 §4
自测|路径很短,为什么开销仍会很大?
- 同一层的 Self-Attention 为什么可以并行?所有位置的投影可由该层输入一起求出,再批量计算任意位置对。
- 二次开销来自哪里?每个 Query 都对所有 Key 打分,共 对。
- 最长路径表示只用常数次计算吗?它数两个位置之间经过几个操作层级。所有位置对同时出现时,计算量仍随 增长。
11|原论文的实验支持哪些结论
Table 2|翻译表现和训练成本
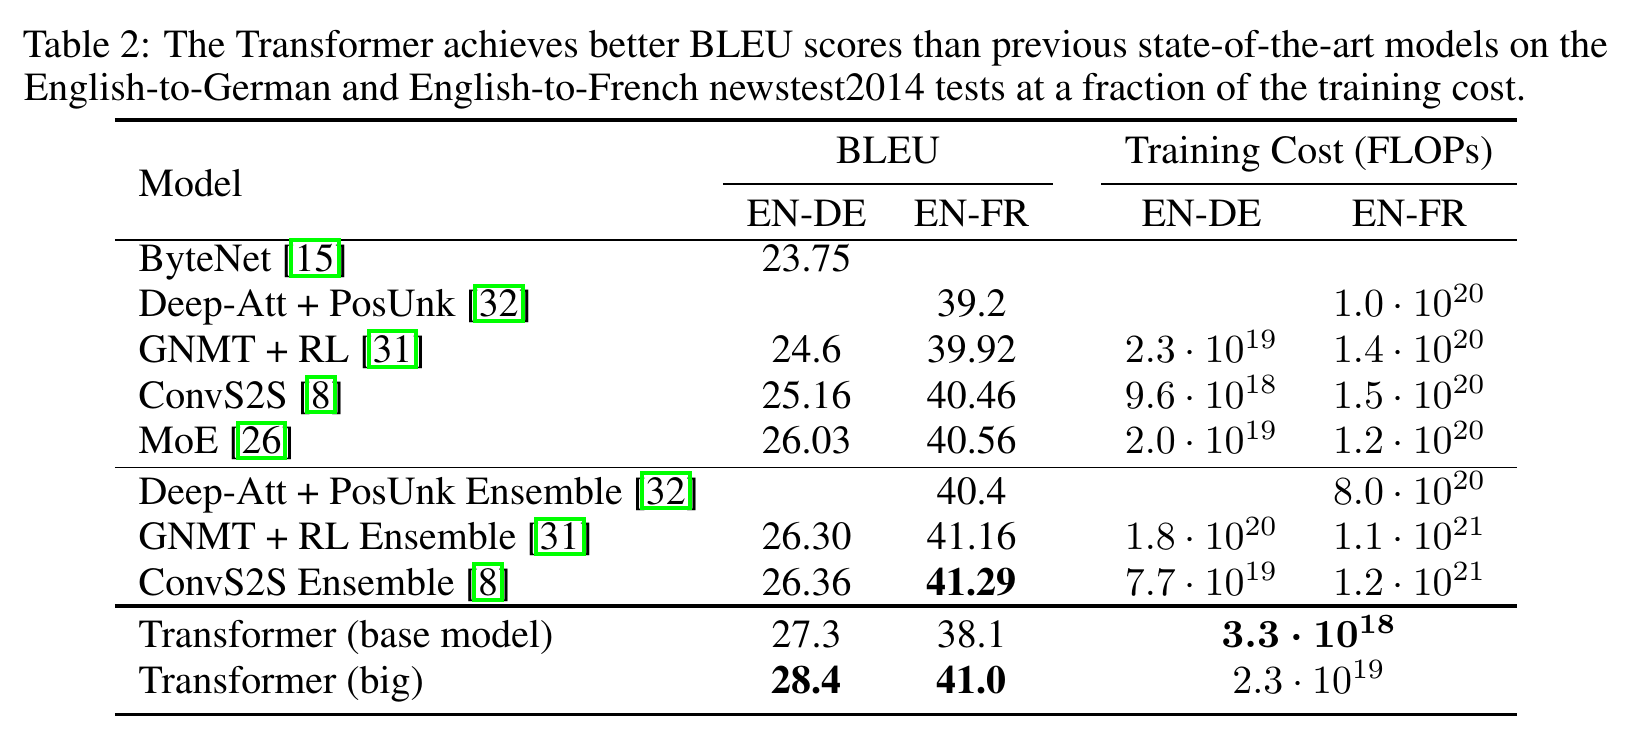
先确定语言方向,再看最下面两行。英德实验中,Base 为 27.3,Big 为 28.4,表中先前最佳集成为 ConvS2S Ensemble 的 26.36。Big 高出约 2.04 BLEU。英法实验中,会议版 Big 为 41.0,高于该表所列此前的单模型结果。表内英法最佳集成是 41.29,因此会议版的英法结论要保留「单模型」这一比较范围。
BLEU 以生成译文与参考译文的 -gram 重合度为基础,另对过短的译文施加惩罚。同一个分数要结合分词、参考译文和测试集理解。原表的 Training Cost 是作者按训练时长、GPU 数量和估计的单卡持续浮点吞吐换算出的 FLOPs。右侧成本列报告的是训练计算量估计。
版本核对。 会议版摘要、Table 2 和 §6.1 对 Big 的英法 BLEU 均为 41.0。arXiv v7 摘要和 Table 2 写 41.8,该版本 §6.1 的对应段落仍写 41.0。上面的对比统一使用会议版 Table 2。 会议版第 8 页 · arXiv v7 §6.1
Table 3|改变一个配置,结果怎么动
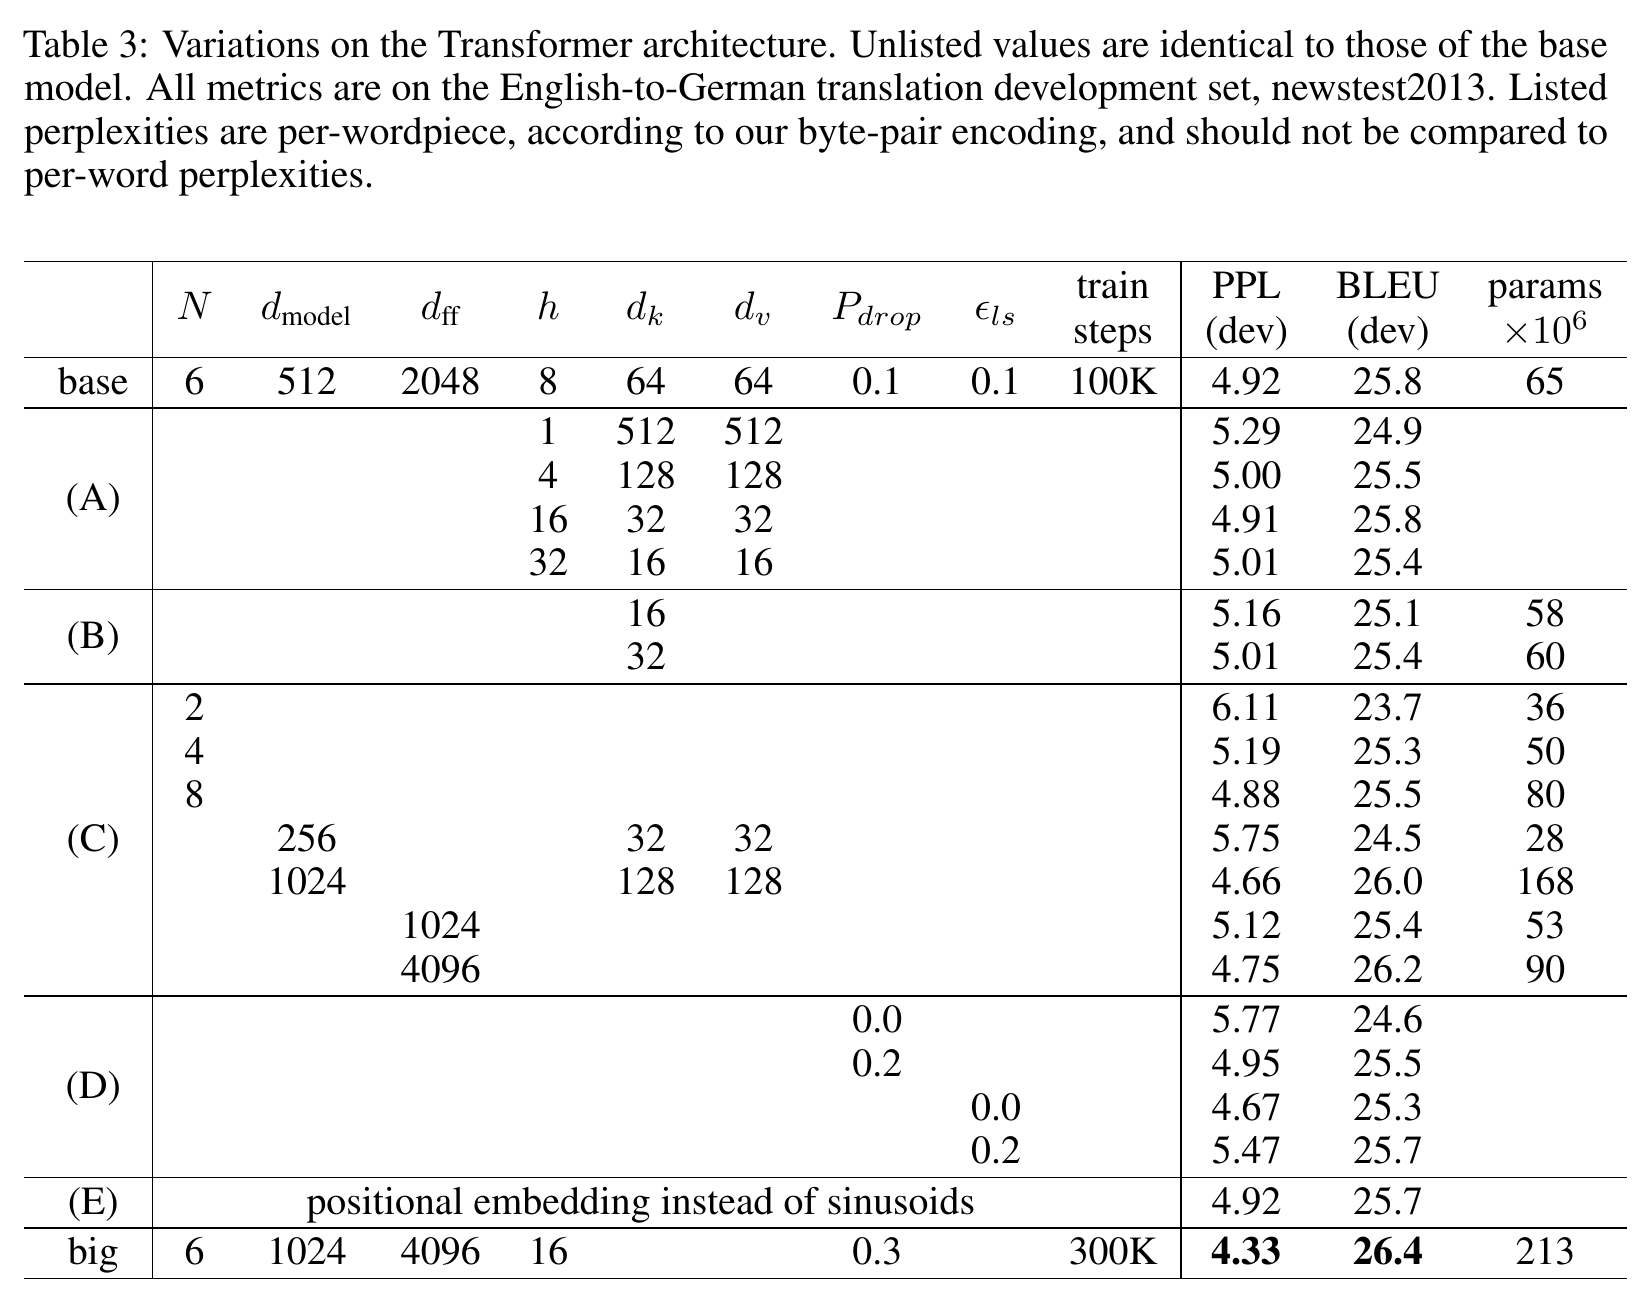
这张表先读 base 行,再看每组改动了哪一列。未列出的值沿用 Base。最后对照的是开发集 BLEU (dev) 和 PPL (dev),数据集与 Table 2 的正式测试集有别。表里的 PPL 按子词单位计算,数值不宜直接和按整词计算的 PPL 比。
- (A) 头数与单头宽度一起变。 总宽保持 512,单头的 BLEU 为 24.9,Base 的八头为 25.8,十六头也是 25.8,三十二头回到 25.4。这个对照给多头配置提供了证据,也显示在固定总宽时继续增加头数的取舍。
- (B) 缩小 。 和 32 时,BLEU 分别为 25.1、25.4,低于 Base 的 25.8。匹配用的特征宽度和模型参数量随设置一起改变。
- (C) 层数、模型宽度与 FFN 宽度。 例如把层数降到 2,BLEU 为 23.7,把层数设为 8 时为 25.5。读这一组时,尤其要留意哪些宽度参数是同时变化的。
- (D) 正则化。 Dropout 设为 0 时 BLEU 为 24.6。标签平滑设为 0 时,PPL 从 Base 的 4.92 降到 4.67,BLEU 从 25.8 降到 25.3。两个指标测量的东西不同,可以朝不同方向变化。
- (E) 位置编码。 用学习的位置向量替换正弦编码,BLEU 为 25.7,接近 Base 的 25.8。这比较的是所报告的开发集条件。
这些实验支持的是具体翻译任务上的架构效果和配置取舍。迁移到很长的序列、不同任务或不同硬件时,需要重新测量质量、内存与耗时。 原论文 §6.2
自测|哪些数字可以放在一起比较?
- BLEU 衡量什么?衡量生成文本与参考译文在短语片段上的重合程度,并带有长度惩罚。
- 为什么单头、多头比较属于消融?作者在 Base 周围改变头数和单头宽度,比较在同一数据集和其他主要设置下结果如何变化。
- Table 3 的 25.8 与 Table 2 的 28.4 能直接用来衡量头数收益吗?它们的评测集和配置都不同。头数收益应从 Table 3 的 (A) 组内读。
12|怎样从公式写出最小 Transformer
这一节实现一个小型 Encoder–Decoder。完整脚本只依赖 Python 和 PyTorch,CPU 上即可运行,数据由脚本生成。模型宽度 32,4 个头,每头 8 维,FFN 中间宽度 64,Encoder 与 Decoder 各 1 层。它保留了本文要检查的运算,使用独立的源词表和目标词表、固定学习率以及贪心解码,适合在很小的例子里逐步调试。 下载完整 PyTorch 源码
python -X utf8 attention_transformer.py先写注意力内核
约定布尔 Mask 的 True 表示可见,False 对应论文中的 。对全部被屏蔽的行先用有限值占位,Softmax 后再把权重清零,以免对整行 归一化时得到 NaN。
def scaled_dot_product_attention(q, k, v, keep=None): scores = q @ k.transpose(-2, -1) / math.sqrt(q.size(-1)) if keep is not None: scores = scores.masked_fill(~keep, -torch.inf) scores = scores.masked_fill(~keep.any(dim=-1, keepdim=True), 0.0) weights = torch.softmax(scores, dim=-1) if keep is not None: weights = weights.masked_fill(~keep, 0.0) return weights @ v, weights沿着形状把组件接起来
- MultiHeadAttention。 分别投影 Q、K、V,再把 reshape 成 并交换轴 1、2。此时分数的乘法是 。输出交换回位置轴在前的排列,再把头和头内特征合并,交给输出投影。
- PositionalEncoding。 按第 05 章公式提前生成正弦和余弦表。前向取前 行,加到每条序列的 个向量上,以同一张表广播到整个批次。
- EncoderLayer。 先送 给自注意力,屏蔽源端的 PAD。做完残差与 LayerNorm,再用同样的 Post-LN 顺序接 FFN。
- DecoderLayer。 先带因果掩码做目标自注意力,随后用更新后的 查询 。交叉注意力用源端 Padding mask。最后接 FFN。
- Transformer。 先用 encode 得到 ,再以目标输入和 调 decode。训练返回词表 logits,交叉熵用右移配对的标签计算。生成时把上一步选出的 Token 拼回前缀再调 decode,复用同一个 。
源码把最后一步写得很短。这里的 tgt 已经是右移的目标输入。
def forward(self, src, tgt): memory, source_keep = self.encode(src) return self.decode(tgt, memory, source_keep)怎样判断代码接对了
先用第 03 章的手算核对数值。再送一组不同长度的 Q/K/V 做形状检查。源码中的一组输入是 Q 为 ,K 为 ,V 为 ,检查得到权重 和输出 。内核支持不同的 ,完整玩具网络使用等宽的头。普通行的权重和应为 1,全部屏蔽的行按上述约定为 0。
因果测试分两步。先在注意力内核里改最后一个位置的 Value,检查前面三行输出是否保持一致。再在整个模型里改目标序列最后一个输入,检查更早的 logits 是否保持一致。训练跑一次 loss.backward() 后,检查参数是否得到有限梯度,并检查第一个 Encoder 自注意力的 Query 投影是否收到非零梯度。
教学脚本实跑结果。 八组玩具句对在一个批次里反复训练 120 步。一次固定种子的 CPU 运行中,训练损失从 2.3247 降到 0.0005,脚本生成下面这句。这次测量用于检查模型和训练循环能否拟合这组训练样本。
shape / probability / mask / gradient checks passedtoy loss: 2.3247 -> 0.0005I love cats -> 我 喜欢 猫 <eos>自测|调试时应该盯哪个轴?
- 为什么 Cross-Attention 的 与 可以不同?一个数目标查询位置,另一个数源候选位置,点积只要求它们的特征宽度一致。
- 只改未来位置输入,哪些输出应该保持一致?所有更早查询位置的输出,在关闭 Dropout 或固定随机性的测试中应相同。
- 拆头之后哪个轴数头?本文使用 ,索引 1 是 Head 轴。
13|综合自测
先闭上图和代码,试着解释每一步,再展开答案。
概念与计算
- Transformer 为什么需要位置机制?不含位置机制的全可见 Self-Attention 在交换两行后会怎样?
- Encoder 自注意力、Decoder 掩码自注意力和交叉注意力各自从哪里取得 Q/K/V?
- 已经做过 Attention,FFN、Residual 和 LayerNorm 各还负责什么?
- 、,权重和输出分别是什么形状?
- 第 03 章的一个 Query、两个 Key 示例,怎么算到最终输出?
- 在长度为 4 的目标序列里,索引 2 的 Query 可以看到哪些 Key?
核对第 1–6 题
- 在全可见情形,交换输入行只会交换相应输出行。PE 把位置的信息加到输入表示。
- Encoder 自注意力全从源端同层输入取得。Decoder 自注意力全从目标端同层输入取得,并加因果掩码。交叉注意力的 Q 读 Decoder 中间状态,K/V 读 Encoder 的最终输出。
- FFN 在每个位置改写特征。Residual 给子层保留输入直达路径。LayerNorm 归一化每个位置的特征,论文把它放在残差相加之后。
- 权重 ,输出 。
- 分数 ,权重约 ,输出约为 。
- 索引 0、1、2。索引 3 被屏蔽。
迁移与实现
- 取消目标端因果掩码后,训练和生成各会出现什么问题?
- 保持模型总宽 512,把八个头换成一个大头,权重的自由度发生了什么变化?
- 原始 Encoder–Decoder Transformer 与常见的 Decoder-only 自回归模型怎样组织源内容?
- 不看图画出模型。标出三处 Attention 的 Q/K/V 和两个位置编码的输入。
- 不调用框架的完整 Transformer 层,实现最小模型,并写一个能抓住未来信息泄漏的测试。
核对第 7–11 题
- 训练时可以从右移输入的后续行读到当前标签。生成时未来输入还没产生,会导致训练与生成的可见条件不一致。
- 原来同一个查询位置有最多八套分别计算的分布。换成单头后,它只有一套位置权重供该头的所有通道使用。
- Encoder–Decoder 先用独立 Encoder 读取源序列,Decoder 用交叉注意力取源信息。常见的 Decoder-only 模型把提示与已生成内容放进同一条因果序列,通过自注意力使用上下文。
- 画出源端 Embedding 加 PE 和目标端 Embedding 加 PE。把 Encoder 输出接到 Decoder 中间注意力的 K/V,Decoder 经过掩码自注意力后的状态接 Q。最后补上残差、归一化、FFN 和词表投影。 对照架构原图
- 固定一条源句和同一目标前缀,复制一份输入,只修改最后一个目标位置。用评估模式计算两次 logits,比较最后一行之前的所有结果。增补形状与梯度断言,再训练小批量,观察损失是否下降。 对照可运行代码
能答 1–3 题,可以用自己的话讲清模块。能做 4–8 题,可以追踪形状并判断掩码是否正确。能独立完成 9–11 题,就可以把同一套检查迁移到自己写的模型上。
课后大题|Transformer / Attention 技术面试
这套题按大模型算法工程师面试的方式练习。每问都先给出明确结论,再用公式、维度或反例说明依据。推导不确定时,标出具体哪一步卡住了。
六轮考察范围
| 轮次 | 重点 | 难度 |
|---|---|---|
| 1 | Self-Attention 的数学性质、Q/K/V 与矩阵维度 | 困难 |
| 2 | 缩放点积、Softmax 与梯度 | 困难 |
| 3 | Multi-Head Attention 的设计与表达能力 | 很困难 |
| 4 | Positional Encoding、Mask 与序列顺序 | 很困难 |
| 5 | Encoder、Decoder 与 Cross-Attention | 困难 |
| 6 | 训练信息泄漏、计算复杂度与实现错误 | 很困难 |
第一轮满分 100 分。 先独立回答 Q1.1–Q1.4,逐问复盘后再做第二题。第一遍先不查资料,从题目给出的 Attention 公式出发。
大题 1|没有位置编码的 Self-Attention 真的不知道顺序吗?(35 分)
设一个标准的 Encoder Self-Attention 层,三个互不相同的向量 按行排成 。不使用位置编码、Attention Mask 或 Dropout, 固定。现在交换 B 和 C 两行。
- Q1.1 交换之后,A 位置的注意力输出向量会发生变化吗?为什么?
- Q1.2 原来 B、C 两个位置的输出向量与交换后的输出向量之间有什么严格关系?
- Q1.3 写出满足 的置换矩阵 ,结合下面的公式证明你的结论。Softmax 按行计算。
- Q1.4(追问) 改用带 Causal Mask 的 Decoder Self-Attention。交换输入时沿用同一个按位置构造的掩码,你在前面得到的置换关系是否仍然成立?说明依据。
大题 2|统一平移 Key 或 Query 会怎样?(30 分)
设单个 Query 为 ,三条 Key 分别为 。考虑给每条 Key 加同一个 ,即 ,Value 保持不变。
- Q2.1 Attention 权重会改变吗?
- Q2.2 Attention 的最终输出会改变吗?
- Q2.3 恢复原来的 Key,只把 Query 改成 。Attention 权重是否一定保持不变?
用 Softmax 的数学性质解释。写出平移前后的 logits,再判断归一化结果会怎样变化。
大题 3|Cross-Attention 的维度与信息泄漏(35 分)
实现原始的 Encoder–Decoder Transformer。张量顺序采用「批次、头、序列位置、特征」。
| 参数 | 给定值 |
|---|---|
| Batch Size | 2 |
| Encoder 输入长度 | 7 |
| Decoder 输入长度 | 4 |
| 模型宽度 | 512 |
| 头数 | 8 |
| 每头 Q/K/V 宽度 | 64 |
- Q3.1 Decoder 的 Cross-Attention 经过线性投影并拆分 Head 后,Q、K、V 各是什么形状?
- Q3.2 计算 后,分数张量是什么形状?每一维对应什么?
- Q3.3 拼接各头并做最终线性投影后,输出是什么形状?
- Q3.4(追问) 训练时,Decoder 的 Cross-Attention 是否需要用 Causal Mask 屏蔽未来位置?结合这个子层的 Q、K、V 各自来自哪条序列说明。
- Q3.5 训练时 Decoder 输入已经右移了一位,为什么 Masked Self-Attention 还要使用 Causal Mask?只右移能防止信息泄漏吗?选一个预测位置,说明它会读到什么。
第一轮评分与复盘
| 分数 | 档位 | 评价依据 |
|---|---|---|
| 90–100 | 优秀 | 能解释机制、完成数学证明并识别反例 |
| 75–89 | 良好 | 核心机制正确,个别边界条件或推导步骤待补齐 |
| 60–74 | 基础合格 | 能追踪主要流程,仍需要把公式和推理连起来 |
| 低于 60 | 需要补强 | 有关键概念混淆,需要回到对应小节复习 |
复盘时逐问标为「完全正确」「推导不完整」或「概念性错误」,写出第一个出错或跳过的步骤。再改一个条件追问,例如换一种掩码或改变 Query 与 Key 的长度,最后记下要补的知识点。
回看最初的翻译例子
生成「猫」之前,中文前缀决定 Decoder 此刻问什么,完整英文提供它可以查什么。Encoder 的输出留在交叉注意力的 K/V 路径里,前缀不断延长,下一步的 Query 随之改变。沿着这两条线读矩阵乘法,就能判断它是在沿特征变换,还是在两个位置之间建立联系。
- Vaswani, A. 等,Attention Is All You Need,NeurIPS 2017。本文原图和实验表统一出自会议版。 NeurIPS 官方 PDF
- 长篇阅读时也可用 HTML 版跳转公式和引用。引用具体实验数字时请标明版本。 arXiv HTML v7 · arXiv PDF v7